全球首个多语言 ColBERT:Jina ColBERT V2 和它的‘俄罗斯套娃’技术
来源:互联网 更新时间:2026-08-27 14:05
在RAG领域,多向量模型ColBERT通过为文档每个token生成独立向量,确实带来了检索精度的提升。但代价也很明显——存储需求急剧膨胀,而且只支持英文,大大限制了它的应用场景。
为了突破这些限制,我们对ColBERT的架构和训练流程做了深度改造,尤其是在多语言处理上下了大功夫。最新的Jina-ColBERT-v2支持89种语言,还加入了可自定义输出维度的设计,存储需求明显减少,多语言检索的效率和准确性都上了一个台阶。
新版本的核心亮点
- :相比原始ColBERT-v2,英文检索性能提升了6.5%;跟前一代jina-colbert-v1-en比,也提升了5.4%。
性能增强
- :新版本一口气支持了89种语言,从阿拉伯语、中文、英语、日语、俄语到编程语言,覆盖面相当广。
多语言支持
- :采用“俄罗斯套娃”式表征学习技术(MRL),提供128、96和64维的输出向量选项,用户可以根据实际需求灵活选择。
输出维度可定制
完整的技术报告可在arXiv上找到:https://arxiv.org/abs/2408.16672
jina-colbert-v2 表现一览
在检索性能上,jina-colbert-v2确实有不少亮点。无论是在英文检索还是多语言支持上,它都甩开了上一代几条街。再加上Jina AI祖传的8192 token输入长度,这款多向量模型的优势得以充分发挥。下面是跟其他版本的对比,改进之处一目了然:
jina-colbert-v2 | jina-colbert-v1-en | 原始 ColBERTv2 | |
|---|---|---|---|
| 英语 BEIR 任务的平均值 | 0.521 | 0.494 | 0.489 |
| 多语言支持 | 89 种语言 | 仅支持英语 | 仅支持英语 |
| 输出维度 | 128、96 或 64 | 固定 128 | 固定 128 |
| 最大查询长度 | 32 tokens | 32 tokens | 32 tokens |
| 最大文档长度 | 8192 tokens | 8192 tokens | 512 tokens |
| 参数数量 | 5.6 亿 | 1.37 亿 | 1.1 亿 |
| 模型大小 | 1.1GB | 550MB | 438MB |
1. 性能提升
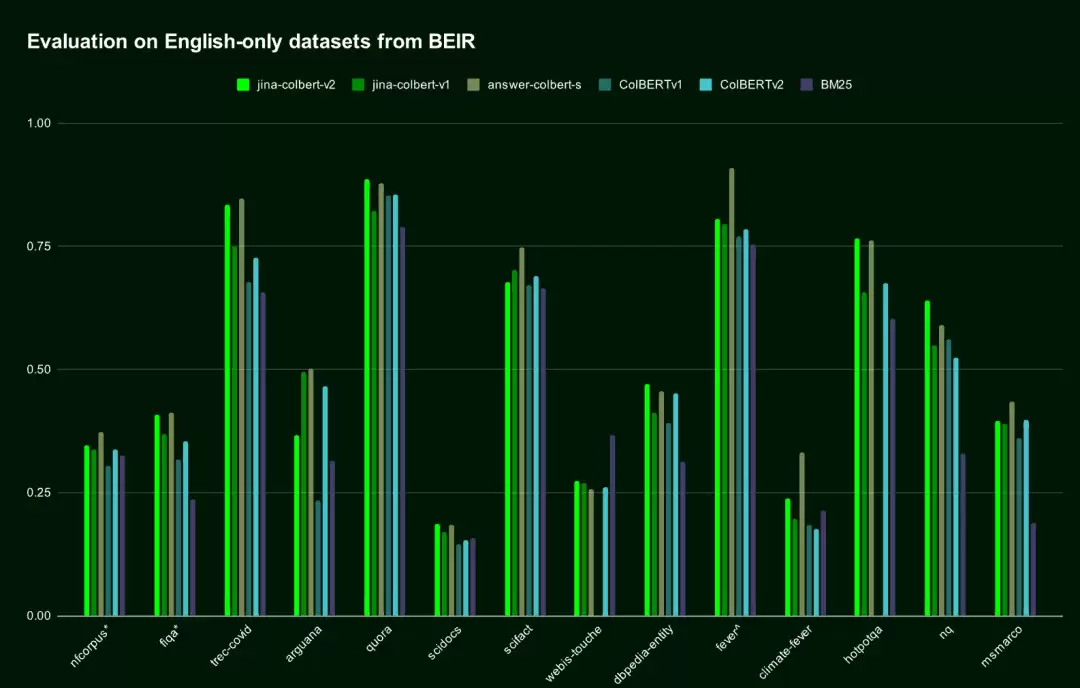
在英语检索任务中,jina-colbert-v2的表现超越了前一代jina-colbert-v1-en和原版ColBERT v2,已经接近专为英语设计的AnswerAI-ColBERT-small模型水平。提升幅度有多大?看BEIR基准测试的平均分就知道了。
| 模型名称 | 英语 BEIR 基准测试的平均分 | 多语言支持 |
|---|---|---|
jina-colbert-v2 | 0.521 | 支持多语言 |
jina-colbert-v1-en | 0.494 | 仅支持英语 |
| ColBERT v2.0 | 0.489 | 仅支持英语 |
| AnswerAI-ColBERT-small | 0.549 | 仅支持英语 |
2. 多语言支持
Jina-ColBERT-v2 是目前唯一一款支持多种语言的 ColBERT 模型
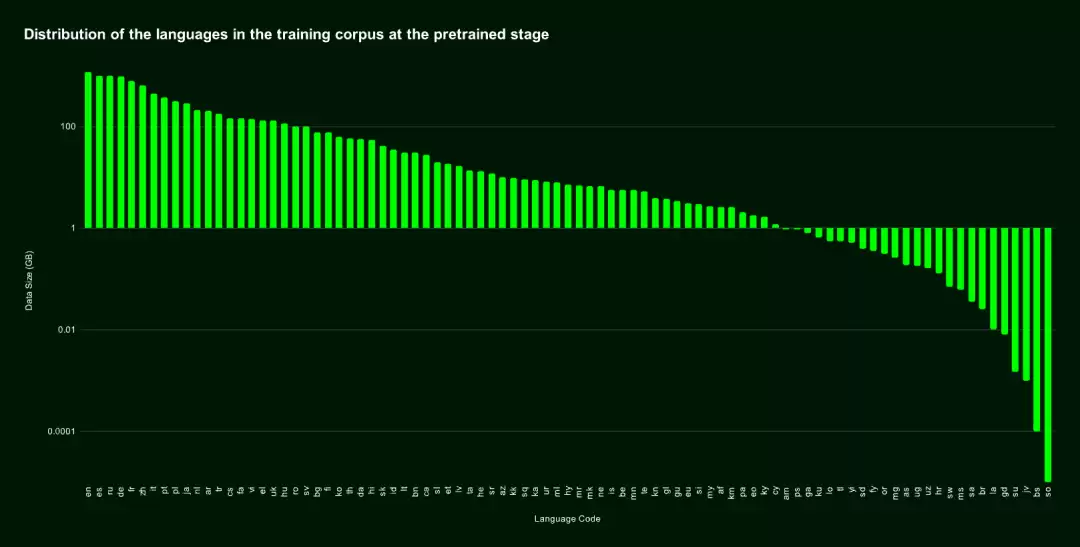
训练语料库覆盖了89种语言,包括4.5亿对弱监督的语义相关句子对、问答对和查询-文档对。其中一半是英语,剩下部分涵盖29种不同的非英语语言,还加入了3.0%的编程语言数据和4.3%的跨语言数据。
对
阿拉伯语、中文、法语、德语、日语、俄语、西班牙语等主流语言
编程语言
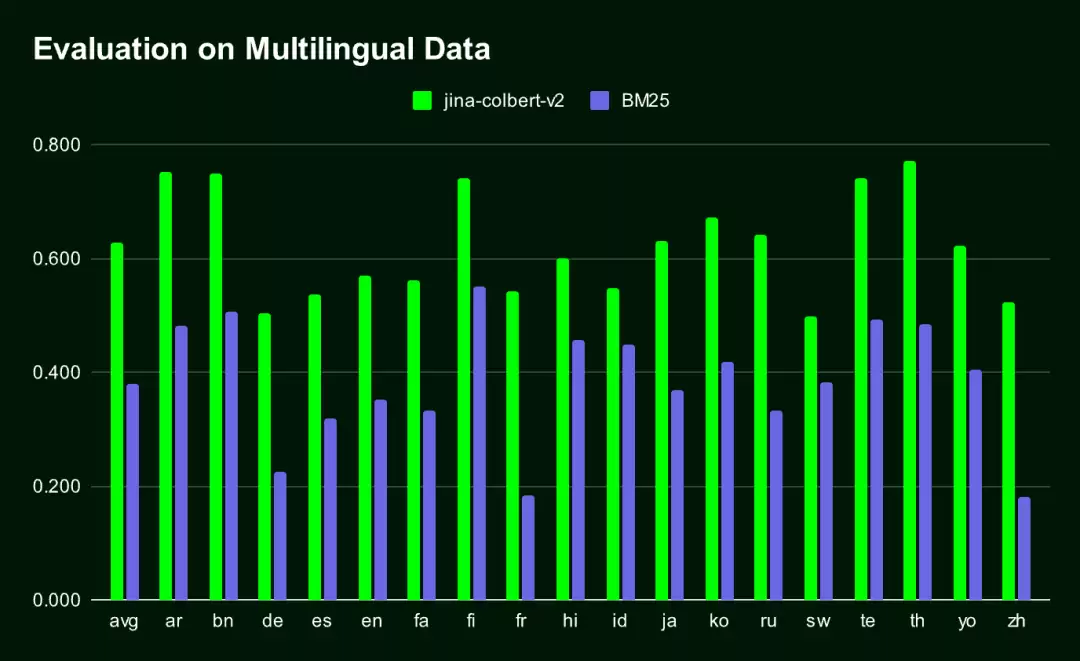
下图展示了在MIRACL基准测试中,Jina-ColBERT-v2和BM25在16种语言上的性能对比。
3. 俄罗斯套娃表征学习
俄罗斯套娃表征学习(MRL)
默认情况下,
Jina-ColBERT-v2 生成128维的Embedding,但你可以选择更短的向量,比如96维或64维
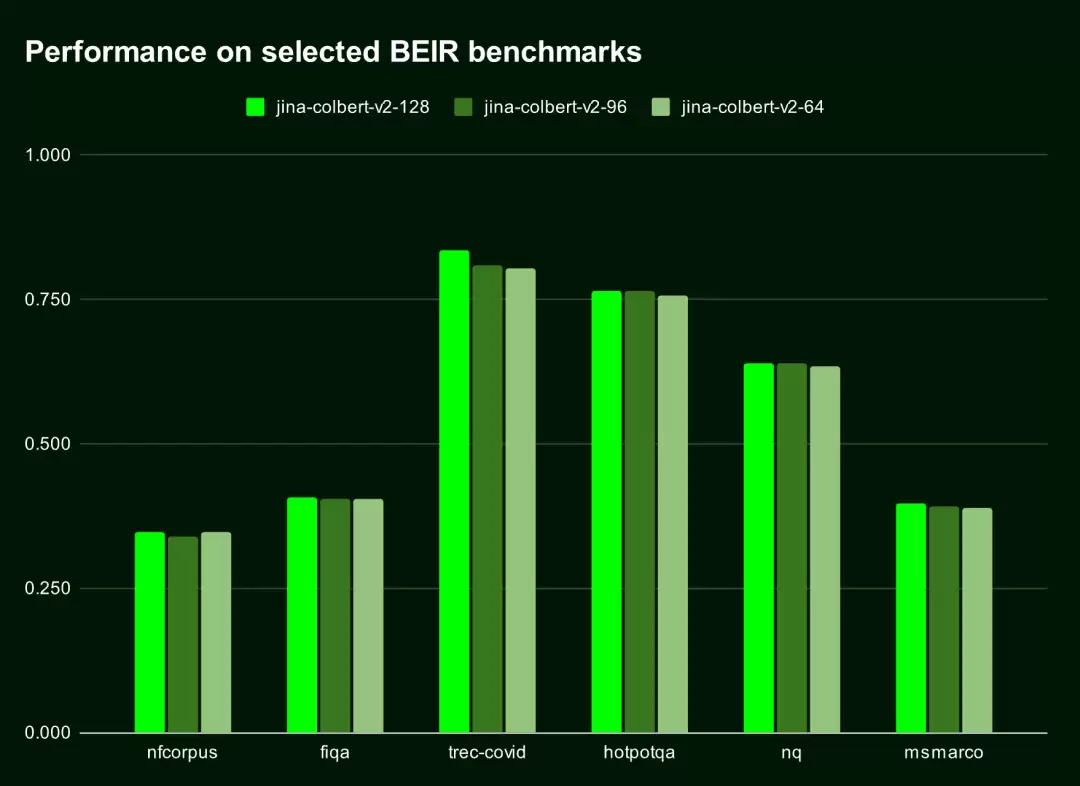
下表展示了Jina-ColBERT-v2在六个BEIR基准测试中前十名结果(nDGC@10)的表现。可以看到,
128维和96维之间的性能差异不到1%,128维和64维之间的差异不到1.5%
| 输出维度 | 平均得分(6 项基准测试的 nDGC@10) |
|---|---|
| 128 | 0.565 |
| 96 | 0.558 |
| 64 | 0.556 |
下图直观地展示了Jina-ColBERT-v2在不同输出维度下的性能表现。
选择较小的输出向量不仅能节省存储空间,还能提升计算速度,尤其是在向量检索系统中需要比较向量或计算距离的场景。成本优势也非常明显:根据Qdrant的云端成本估算器,在AWS上存储1亿个文档,128维向量的费用是每月1319.24美元,而使用64维向量,费用直接减半,降到每月659.62美元。速度更快,成本更低。
如何开始使用 Jina ColBERT v2
Jina ColBERT v2已经上线Jina Search Foundation API、AWS Marketplace和Azure平台。此外,它还以CC BY-NC-4.0许可证在Hugging Face上开源,供非商业用途使用。
AWS Marketplace: https://aws.amazon.com/marketplace/seller-profile?id=seller-stch2ludm6vgy
Azure: https://azuremarketplace.microsoft.com/en-gb/marketplace/apps?search=Jina
Hugging Face: https://huggingface.co/jinaai/jina-colbert-v2
通过 Jina Search Foundation API
用于 Embedding
使用Jina Embedding API获取jina-colbert-v2的Embedding是最简单直接的方式。两个关键参数需要留意:
dimensions:表示Embedding的输出维度,默认为128,也可以选择64。
input_type:决定输入类型,query的最大长度限制为32 token,超过部分自动截断;document最长可达8192 token。文档编码可以离线处理,查询时只需要编码查询部分,处理速度会显著提高。
Jina API Key在jina.ai/embeddings获取。
curl https://api.jina.ai/v1/multi-vector \
     -H "Content-Type: application/json" \
     -H "Authorization: Bearer " \
     -d '{
     "model": "jina-colbert-v2",
     "dimensions": 128, # 或 64
     "input_type": "document", # 这里需要注意input_type 是 document 还是 query
     "embedding_type": "float",
     "input": [
         "在此输入你的文档文本",
         "你可以发送多个文本",
         "每个文本最长可达 8192 个标记"
    ]}'
用于 Reranker
要通过Jina Reranker API使用jina-colbert-v2,传入一个查询和多个文档,它会返回可Reranker的匹配分数。构造如下请求:
curl https://api.jina.ai/v1/rerank \
     -H "Content-Type: application/json" \
     -H "Authorization: Bearer " \
     -d '{
      "model": "jina-colbert-v2",
      "query": "柏林的人口是多少?",
      "top_n": 3,
      "documents": [
        "2023年柏林的人口比去年增长了0.7%。因此,到去年年底,柏林的居民人数比2022年增加了约27300人。30岁到40岁的人群是数量最多的年龄组。柏林拥有约88.1万外国居民,来自约170个国家,平均年龄为42.5岁。",
        "柏林山是南极洲玛丽·伯德地的一个冰川覆盖的火山,距离阿蒙森海约100公里(62英里)。它是一个宽约20公里(12英里)的山峰,有寄生火山口,由两座合并的火山组成:柏林火山,其火山口宽2公里(1.2英里),以及距离柏林火山约3.5公里(2.2英里)的Merrem峰,火山口宽2.5×1公里(1.55英里×0.62英里)。",
        "截至2023年12月31日,各联邦州按国籍和州统计的人口数据",
        "柏林的都市区人口超过450万,是德国人口最多的都市区。柏林-勃兰登堡首都地区约有620万人口,是德国第二大都市区,仅次于莱茵-鲁尔区,并且是欧盟第六大都市区(按GDP计算)。",
        "欧文·柏林(原名以色列·贝林)是一位美国作曲家和词曲作者。他的音乐是《伟大的美国歌本》的一部分。柏林获得了许多荣誉,包括奥斯卡奖、格莱美奖和托尼奖。",
        "柏林是美国康涅狄格州首都规划区的一个城镇。2020年人口普查时人口为20,175。",
        "柏林是德国的首都和最大城市,无论是面积还是人口。其超过385万居民使其成为欧盟人口最多的城市(按城市限界内人口计算)。",
        "《柏林,柏林》是一部为ARD制作的电视剧,于2002年至2005年在德国第一电视台的晚间节目中播出。导演包括弗朗茨斯卡·迈耶·普莱斯、克里斯托夫·施内、斯文·温特瓦尔特和蒂图斯·塞尔格。"
        ]
    }'
top_n参数控制返回的文档数量,如果只需要最优匹配结果,可以设为1。
更多Python或其他语言的示例代码,请访问jina.ai/embeddings页面,或在jina.ai/reranker/的下拉菜单中选择jina-colbert-v2。
通过 Stanford ColBERT
如果你用过Stanford ColBERT库,现在可以无缝替换成Jina ColBERT v2版本。只需要指定jinaai/jina-colbert-v2作为模型源。
from colbert.infra import ColBERTConfig
from colbert.modeling.checkpoint import Checkpoint

ckpt = Checkpoint("jinaai/jina-colbert-v2", colbert_config=ColBERTConfig())
docs = ["你的文本列表"]
query_vectors = ckpt.queryFromText(docs)
通过 RAGatouille
Jina ColBERT v2同样集成在RAGatouille系统中,通过RAGPretrainedModel.from_pretrained()方法就能下载使用,非常方便。
from ragatouille import RAGPretrainedModel

RAG = RAGPretrainedModel.from_pretrained("jinaai/jina-colbert-v2")
docs = ["你的文本列表"]
RAG.index(docs, index_name="your_index_name")
query = "你的查询"
results = RAG.search(query)
通过 Qdrant
Qdrant从1.10版本开始支持多向量和迟交互模型,你可以直接使用jina-colbert-v2。无论是本地部署还是云端托管,只需要在客户端中正确配置multivector_config参数,就可以把文档插入到多向量集合中。
使用 MAX_SIM 操作创建新集合
from qdrant_client import QdrantClient, models

qdrant_client = QdrantClient(
    url="",
    api_key="",
)

qdrant_client.create_collection(
    collection_name="{collection_name}",
    vectors_config={
        "colbert": models.VectorParams(
            size=128,
            distance=models.Distance.COSINE,
            multivector_config=models.MultiVectorConfig(
                comparator=models.MultiVectorComparator.MAX_SIM
            ),
        )
    }
)
⚠️ 正确设置multivector_config参数是在Qdrant中使用ColBERT模型的关键。
将文档插入多向量集合
import requests
from qdrant_client import QdrantClient, models

url = 'https://api.jina.ai/v1/multi-vector'

headers = {
    'Content-Type': 'application/json',
    'Authorization': 'Bearer '
}

data = {
    'model': 'jina-colbert-v2',
    'input_type': 'query',
    'embedding_type': 'float',
    'input': [
        '在此输入你的文本',
        '你可以发送多个文本',
        '每个文本最长可达 8192 个标记'
    ]
}

response = requests.post(url, headers=headers, json=data)
rows = response.json()["data"]

qdrant_client = QdrantClient(
    url="",
    api_key="",
)

for i, row in enumerate(rows):
    qdrant_client.upsert(
        collection_name="{collection_name}",
        points=[
            models.PointStruct(
                id=i,
                vector=row["embeddings"],
                payload={"text": data["input"][i]}
            )
        ],
    )
查询集合
from qdrant_client import QdrantClient, models
import requests

url = 'https://api.jina.ai/v1/multi-vector'

headers = {
    'Content-Type': 'application/json',
    'Authorization': 'Bearer '
}

data = {
    'model': 'jina-colbert-v2',
    "input_type": "query",
    "embedding_type": "float",
    "input": [
        "Jina AI 的Embedding模型支持多少个标记的输入?"
    ]
}

response = requests.post(url, headers=headers, json=data)
vector = response.json()["data"][0]["embeddings"]

qdrant_client = QdrantClient(
    url="",
    api_key="",
)

results = qdrant_client.query_points(
    collection_name="{collection_name}",
    query=vector,
)

print(results)
-
ELON币发展前景怎么样?未来潜力如何?ELON价格走势分析
-
黄金和比特币走势是相反吗?黄金和比特币哪个价值高?
-
豆包app正版免费版下载 豆包安卓正版安装包下载
-
55部泰腐剧全盘点,从《千星传说》到《以你的心诠释我的爱》
-
豆包app官方下载 豆包官方免费下载安装
-
LITH币可以长期持有吗?LITH币价格最新行情
-
电视剧《温柔的谎言》剧情介绍
-
CCTV-1黄金档《藏锋》今晚首播!
-
2026暑期档票房破100亿:《功夫女足》《八仙!》TOP2
-
vivo手机怎么设置来电闪光灯 vivo手机来电提醒设置教程
-
盘搜搜搜索入口地址 盘搜搜网盘资源在线查找入口
-
石头P30 Pro发布:8.98cm超薄热活水扫拖机器人
-
短剧《我本无念,奈何我有神之眼》剧情介绍
-
三款26年75寸Mini LED 电视横评|创维 A7H
-
2026磁轴键盘超短触发选购指南
-
iPhone 18支持多少瓦快充 苹果18选购适配器充电器推荐
-
电视剧《她的罪名》剧情介绍
-
闺蜜网名高冷女生(精选100个)
-
短剧《谁敢动我的家人》剧情介绍
-
硅基流动怎么用Flux画图?超高性价比生图调用指南
-
1

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
2
- 我好喜欢你是什么梗?
- 角色扮演 |
-
3
- 新学期开学季祝福语简短励志(15篇)
- 角色扮演 |
-
4
- 60年校庆贺词大全
- 角色扮演 |
-
5
- 五一节假日经典祝福贺词
- 角色扮演 |
-
1 免费还超快,我用 Cursor 做的“汉语新解”插件开源了 08-27
-
2 o1模型的逆向工程:架构解析 08-27
-
3 o1模型在ARC挑战赛的评测与分析 08-27
-
4 OpenAI o1: 合成数据与推理搜索 08-27
-
6 RPA与AI结合在客户服务中的创新应用 08-27
-
7 解码生成式AI发展的新兴趋势与关键节点 08-27
-
8 财务RPA与AI技术在智能决策中的结合 08-27
-
9 AI技术是如何让文档智能分类与检索的 08-27
-
10 生成式AI的八大发展趋势预测 08-27