大模型对齐技术的综合评述:RLHF、RLAIF、PPO、DPO及更多(一)
来源:互联网 更新时间:2026-08-27 14:15
大模型对齐技术的综合评述:RLHF、RLAIF、PPO、DPO及更多(一)
自监督学习在过去十几年里一路狂飙,直接带动了大模型能力的飞跃。海量语料训练加上Transformer架构的规模效应,让LLM在回答问题时既能保持事实准确,又能做到语句连贯。在自然语言处理、对话系统、机器翻译这些领域,它们已经展现出了惊人的实力。但问题也随之而来——训练数据质量参差不齐,模型偶尔会蹦出一些不合时宜的内容,比如教人怎么干违法的事。这就给实际落地带来了不小的隐患。
为了把这些“野马”缰绳拉紧,研究人员从各个方向祭出了多种对齐方案,核心目标只有一个:让模型输出更符合人类期望。Salesforce的研究团队发布了一篇综述论文《A COMPREHENSIVE SURVEY OF LLM ALIGNMENT TECHNIQUES: RLHF, RLAIF, PPO, DPO AND MORE》,把这摊子事儿梳理得清清楚楚。
下面我们就跟着这篇论文的框架,把奖励模型、反馈机制、强化学习和优化方法这些对齐技术挨个拆开看看,尽量让读者对整个领域的现状有个全景式认识。文中还整理了一份论文清单表格(部分论文有单独的解读文章),方便对照查阅。
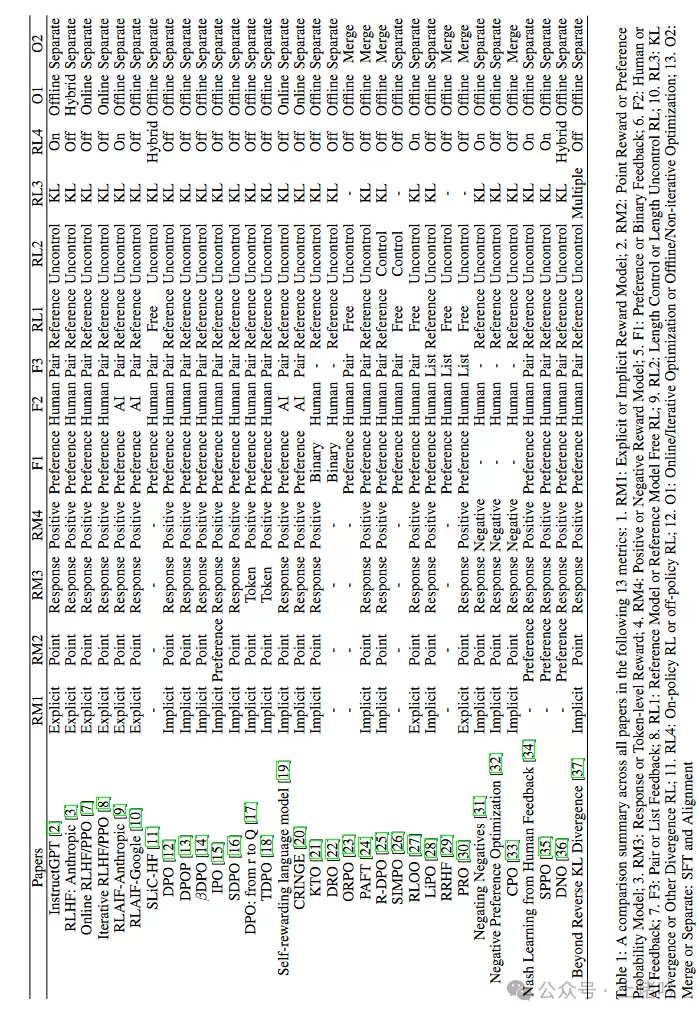
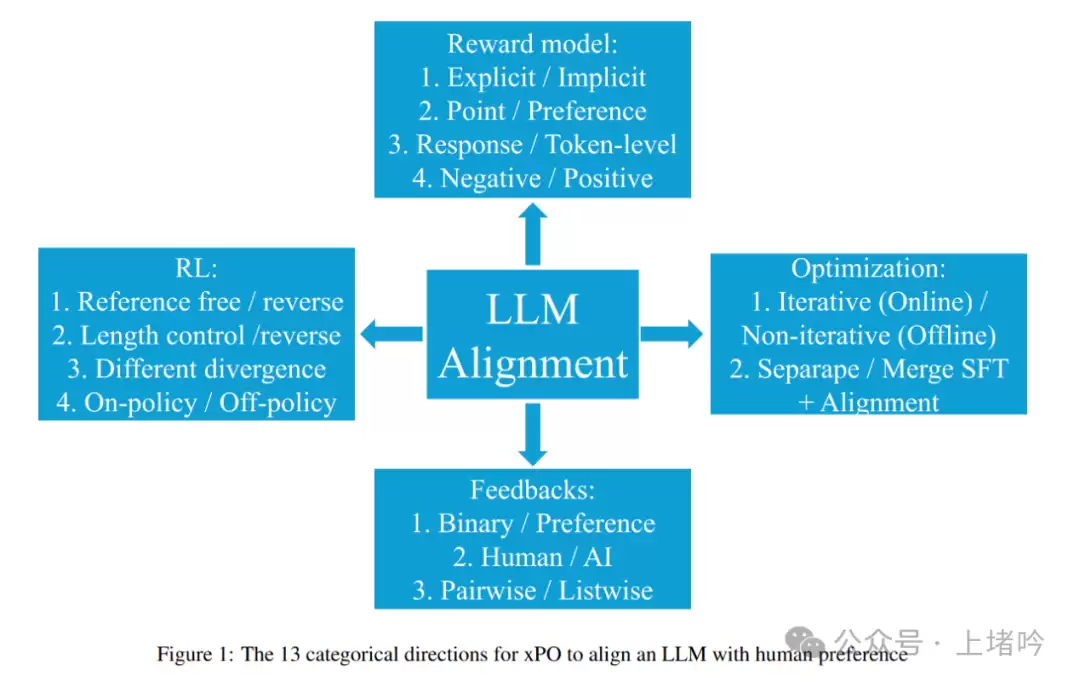
具体来说,本文会用结构化的方式依次评述:奖励模型(显式与隐式、点奖励与偏好模型、响应级与令牌级奖励、负偏好优化);反馈机制(偏好反馈与二元反馈、成对与列表反馈、人类反馈与AI反馈);强化学习方法(基于参考与无参考、长度控制、不同散度度量、on-policy与off-policy);优化方法(在线/迭代与离线/非迭代、分离SFT与合并SFT)。最后还会挑几个代表性论文深挖一下,比如RLHF/PPO、RLAIF、DPO这些。
1. 对齐技术的分类概述
大模型对齐的核心挑战,就是让模型输出既强大又靠谱。不同技术方案的侧重点各不相同,把它们分类整理出来,能更清楚地看到各自的底牌和适用场景。
1.1 奖励模型
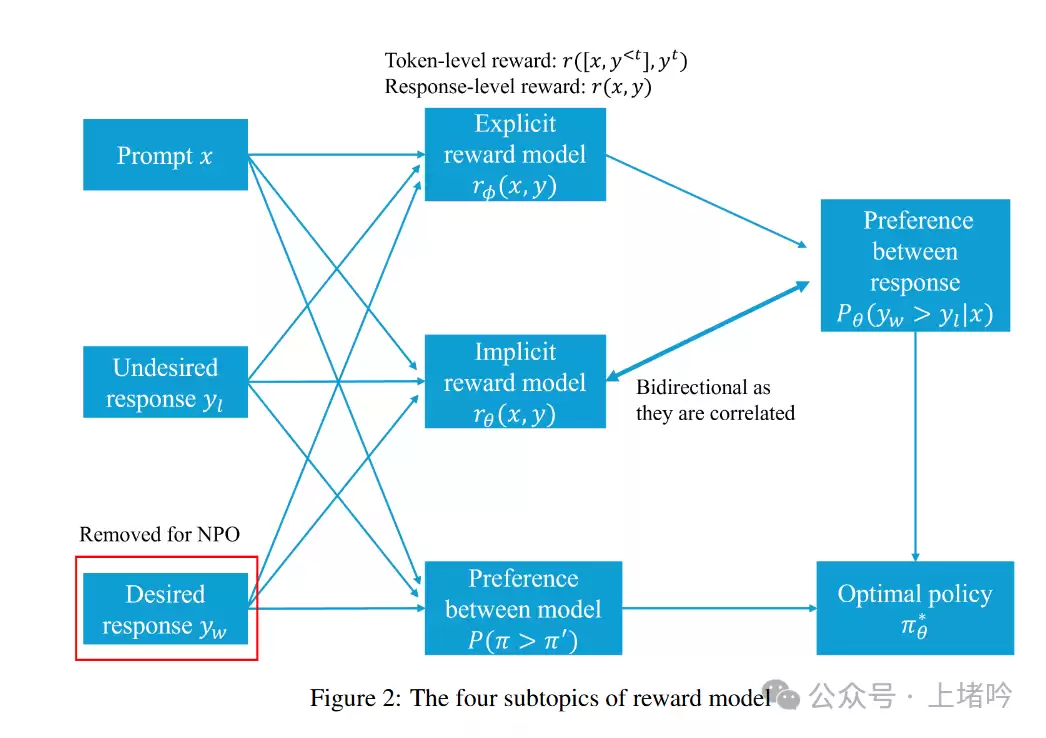
奖励模型是对齐流程中的“裁判员”。它给模型的每个输出打分,这些分数就是强化学习优化策略的依据。论文在分析奖励模型时,拆成了四个维度来谈。
1.1.1 显式奖励模型与隐式奖励模型
显式奖励模型通过人工标注数据训练,明确地给每个输入-输出对打一个分数。这种方法透明、可解释,但代价也很具体:需要大量高质量标注数据,成本高、获取难。
隐式奖励模型则绕开了明确的奖励函数,直接从策略中学习偏好排序。DPO(直接偏好优化)就是典型代表——它不需要显式的奖励模型,直接优化策略来匹配偏好。好处是数据依赖小、计算开销低,但遇到复杂任务时解释性可能打折扣,这也是后续研究方向。
1.1.2 点对点奖励模型与偏好模型
点对点奖励模型给每个响应一个独立分数,评估单个响应的质量很直观。但当需要比较多个响应时,单点分数的局限性就暴露了——它很难捕捉人类偏好在不同响应之间的微妙差别。
偏好模型则通过两两比较或群体排序来确定哪个更符合人类喜好。这种方法能更好地抓住那些细微差异,在复杂对齐任务中表现出更强的鲁棒性。实验显示,偏好模型能显著提升输出的一致性和相关性,减少误差传播导致的训练抖动。
1.1.3 响应级奖励与词级奖励
响应级奖励对整个输出序列统一打分,在NLP任务中最常用。但模型越复杂、生成的文本越长,这种粗粒度打分就越难反映出局部质量问题。
词级奖励则在每个生成的词后立刻给分,能精细地指导生成过程。比如在强化学习框架下,词级奖励可以及时纠正某个词的错误选择,避免错误累积。不少实验表明,它在准确性和流畅性上都有明显提升。
1.1.4 负偏好优化
大多数奖励模型都忙着“褒奖”好输出,但坏输出怎么办?负偏好优化专门处理这个死角——让模型学会识别和规避低质量、不符合预期的输出。实验证明,这种方法不仅能减少有害内容生成,还能提升模型在未标注数据上的泛化能力。对那些需要严格把控输出安全性的场景,它格外有用。
1.2 反馈机制
反馈是驱动模型优化的燃料。没有高质量的反馈,再好的策略也转不起来。
1.2.1 偏好反馈与二元反馈
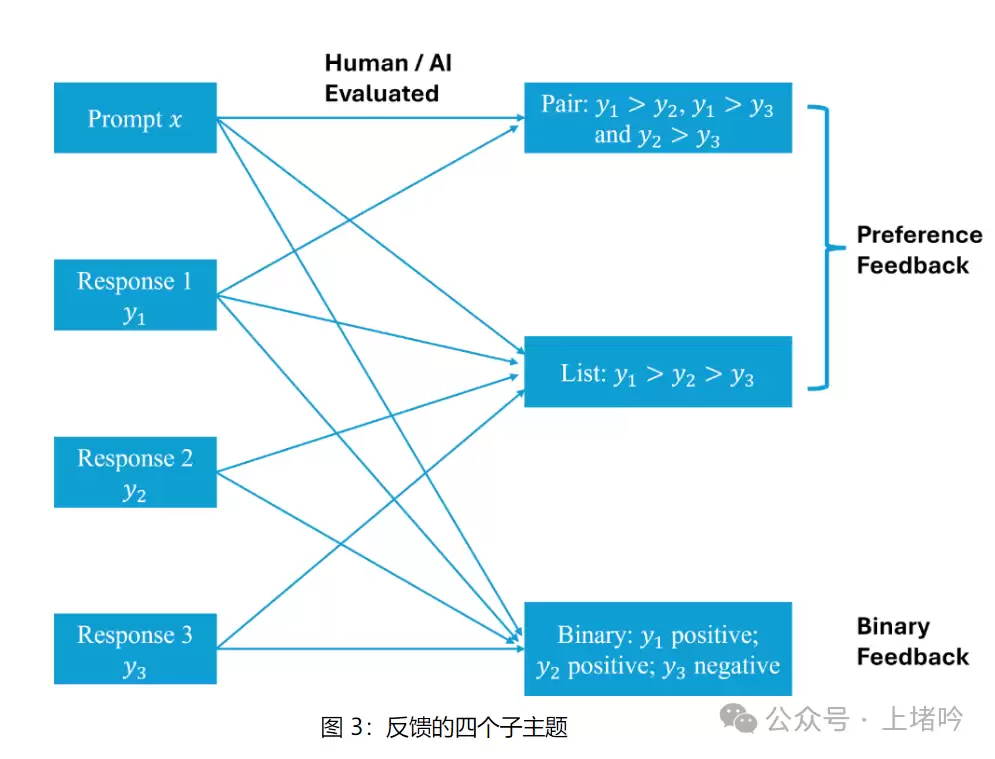
偏好反馈通过比较两个或多个响应来获取信息,信息量丰富,能帮模型理解复杂的偏好需求。多轮对话或复杂决策任务中,偏好反馈的优势非常明显。
二元反馈则简单粗暴,只给“好”或“坏”的判断。虽然信息量有限,但胜在实现方便、效率高。在反馈数据不足或需要快速迭代的场景下,它依然是最实用的选择。
1.2.2 成对反馈与列表反馈
成对反馈就是两两比较,哪个更好。这是强化学习早期最常用的方式,但面对复杂任务时效率可能跟不上。
列表反馈则一次性比较多个响应,得到完整排序。这种方法能更全面地捕捉人类偏好,特别适合需要细粒度判断的任务。研究显示,列表反馈在复杂对齐中能显著提升效果,同时降低误差累积导致的训练不稳定。
1.2.3 人工反馈与AI反馈
人工反馈是经典的“老师傅带徒弟”——通过标注数据引导模型。但成本高、速度慢,而且标注者主观偏见也会引入噪声。
AI反馈用预训练模型自动生成反馈,很大程度上解决了人工瓶颈。把人类反馈和AI反馈结合起来,可以在降低标注成本的同时保持对齐效果的稳定性。在大数据和复杂任务中,这种混合模式潜力巨大。
1.3 强化学习
强化学习是对齐流程中的“发动机”。模型通过与环境不断互动,逐步优化生成策略,让奖励越滚越大。
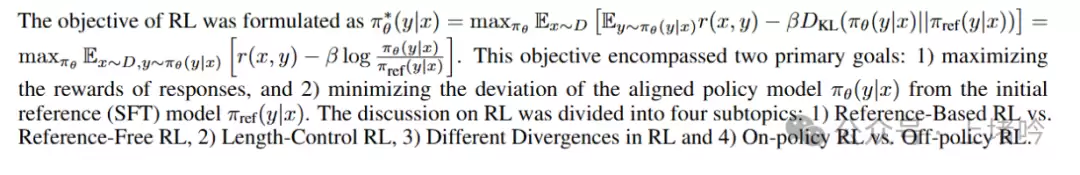
1.3.1 基于参考的RL与无参考的RL
基于参考的RL设定一个标准策略作为基准,模型在优化时往这个基准靠,或者超越它。效果不错,但计算资源消耗大,大模型场景下尤其吃力。
无参考的RL直接优化策略本身,不依赖外部参考。好处是计算开销低、训练效率高,能避开参考策略带来的瓶颈。在处理复杂任务和大规模数据时,优势相当突出。
1.3.2 长度控制的RL
大模型似乎天生爱“话多”——容易生成又长又绕的响应,但实际用户往往只需要精炼的回答。怎么在强化学习中把生成长度管起来,成了一个关键课题。
引入长度控制机制后,模型可以在训练过程中对输出长度进行精细调节。实验表明,在那些需要短小精悍回答的任务上,长度控制的RL能显著提升表现,同时省下不必要的计算开销。
1.3.3 不同散度在RL中的应用
散度用来衡量策略分布之间的差异,它的选择直接影响优化效果。KL散度是常用工具,通过最小化当前策略与参考策略的KL散度来约束生成行为。但KL散度有时会导致多样性下降——输出变得过于保守。于是研究者开始尝试反向KL散度、Jensen-Shannon散度等其他指标,以适应不同任务需求。这些探索不仅丰富了理论工具箱,也让实践中的对齐更加灵活。
1.3.4 策略内学习与策略外学习
策略内学习(On-policy)每一步都用最新策略生成数据并更新,能确保优化方向始终匹配当前策略。适合需要持续实时调整的场景。
策略外学习(Off-policy)则复用之前生成的数据来更新,计算效率高,但缺点是旧数据可能跟当前策略不大匹配,影响优化效果。实践中,把两者结合起来往往能扬长避短——既保证生成质量,又提高计算效率和训练稳定性。
1.4 优化方法
优化的目的是在计算资源和生成质量之间找到最佳平衡点,让对齐效果最大化。
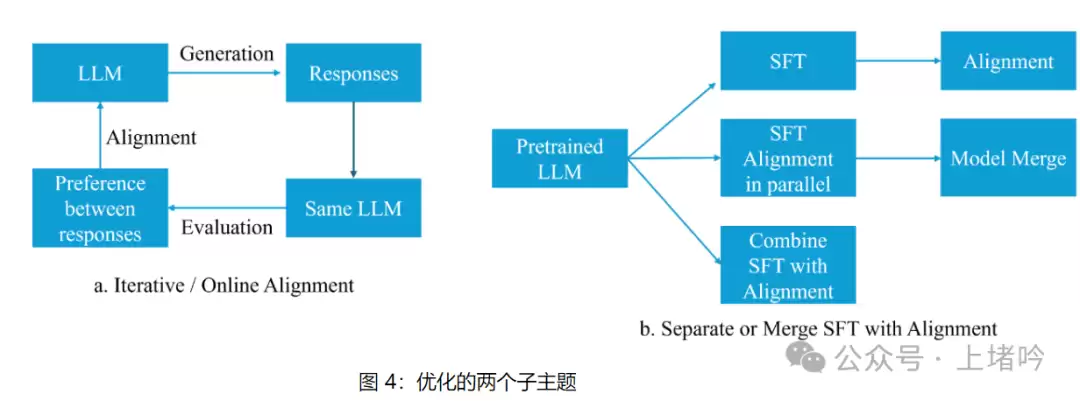
1.4.1 在线/迭代偏好优化与离线/非迭代偏好优化
在线偏好优化不断拿新反馈数据来实时调整策略,让模型输出始终跟最新需求对齐。迭代优化则是在每轮优化后评估效果,再决定下一步改哪里。实验显示,这两种方法在复杂任务中能显著提升对齐效果,减少因数据不足导致的泛化问题。
离线偏好优化和非迭代优化更适合反馈数据少或者获取成本高的场景。它们把有限的现有数据用到极致,同样能在特定任务上取得不错的效果,而且计算资源更省。
1.4.2 将监督微调与对齐分开或合并
传统做法是把监督微调(SFT)和对齐分成两个独立阶段。但任务越来越复杂后,这种分离式策略在效率和效果上开始暴露出问题——误差可能在阶段之间累积。
把SFT和对齐合并到一个框架里,就可以同时优化生成质量和对齐效果。这样不仅简化了训练流程,多个实验也证明合并策略在大规模数据和复杂任务上的适应性更强、鲁棒性更好。
从上面的分类梳理可以清楚看到,不同对齐技术各有侧重,但它们在模型优化和生成质量提升上缺一不可。未来这些技术还会进一步融合演化,为大模型的高效对齐提供更全面的支持。
1.5 综合应用与技术关系
在实际项目里,奖励模型、反馈机制、强化学习方法和优化方法往往是组合在一起的,构成一个完整的对齐生态系统。
- ——核心裁判,给输出打分。可以是显性的(直接打分)或隐性的(间接优化),可以是点奖励(单响应评分)或偏好模型(比较多个响应)。
奖励模型
- ——数据的来源。通过人类或AI提供的偏好反馈或二元反馈,为奖励模型提供训练数据。成对反馈和列表反馈是两种主流收集方式。
反馈机制
- ——用奖励信号驱动策略优化。基于参考的RL以预训练模型为基准,无参考RL直接优化;长度控制RL考虑生成长度;不同散度度量用来约束策略差异;On-policy和Off-policy则提供不同的数据使用策略。
强化学习方法
- ——决定训练过程的具体实现。在线/迭代优化通过实时反馈逐步推进,离线/非迭代优化则利用固定数据集做一次性优化。分离SFT与对齐是分阶段走,合并SFT与对齐则是同时进行。
优化方法
1.5.1 典型应用范式
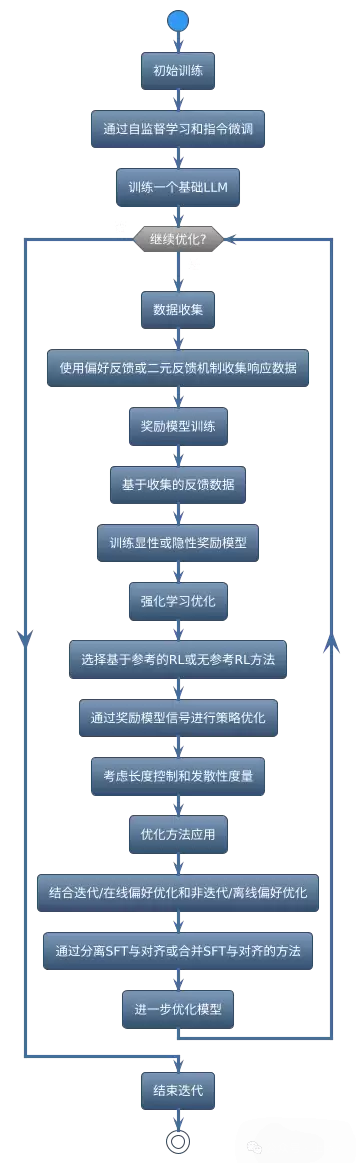
参照论文的框架,一个典型的LLM对齐应用范式大致如下:
- ——通过自监督学习和指令微调,先训练出一个基础LLM。
初始训练
- ——用偏好反馈或二元反馈机制,收集成对或列表的响应数据。
数据收集
- ——基于收集的反馈数据,训练显式或隐式奖励模型。
奖励模型训练
- ——选择基于参考或无参考的RL方法,用奖励模型提供的信号做策略优化,同时考虑长度控制和散度度量。
强化学习优化
- ——结合在线/迭代与离线/非迭代方法,通过分离或合并SFT进一步优化。
优化方法应用
- ——不断收集新数据,更新奖励模型和策略,周而复始,逐步提升模型性能。
循环迭代
按照这个流程,就能搭建一个相对高效、可靠的对齐系统,让大模型生成的内容更贴近人类期望,实用性和安全性也更有保障。
未完待续
参考论文:arXiv:2407.16216v1 [cs.CL] 23 Jul 2024
-
ELON币发展前景怎么样?未来潜力如何?ELON价格走势分析
-
黄金和比特币走势是相反吗?黄金和比特币哪个价值高?
-
豆包app正版免费版下载 豆包安卓正版安装包下载
-
55部泰腐剧全盘点,从《千星传说》到《以你的心诠释我的爱》
-
豆包app官方下载 豆包官方免费下载安装
-
LITH币可以长期持有吗?LITH币价格最新行情
-
电视剧《温柔的谎言》剧情介绍
-
CCTV-1黄金档《藏锋》今晚首播!
-
2026暑期档票房破100亿:《功夫女足》《八仙!》TOP2
-
石头P30 Pro发布:8.98cm超薄热活水扫拖机器人
-
vivo手机怎么设置来电闪光灯 vivo手机来电提醒设置教程
-
盘搜搜搜索入口地址 盘搜搜网盘资源在线查找入口
-
短剧《我本无念,奈何我有神之眼》剧情介绍
-
三款26年75寸Mini LED 电视横评|创维 A7H
-
短剧《云端负烟火》剧情介绍
-
2026磁轴键盘超短触发选购指南
-
iPhone 18支持多少瓦快充 苹果18选购适配器充电器推荐
-
电视剧《她的罪名》剧情介绍
-
闺蜜网名高冷女生(精选100个)
-
短剧《谁敢动我的家人》剧情介绍
-
1

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
2
- 我好喜欢你是什么梗?
- 角色扮演 |
-
3
- 新学期开学季祝福语简短励志(15篇)
- 角色扮演 |
-
4
- 60年校庆贺词大全
- 角色扮演 |
-
5
- 五一节假日经典祝福贺词
- 角色扮演 |
-
1 免费还超快,我用 Cursor 做的“汉语新解”插件开源了 08-27
-
2 o1模型的逆向工程:架构解析 08-27
-
3 o1模型在ARC挑战赛的评测与分析 08-27
-
4 OpenAI o1: 合成数据与推理搜索 08-27
-
6 RPA与AI结合在客户服务中的创新应用 08-27
-
7 解码生成式AI发展的新兴趋势与关键节点 08-27
-
8 财务RPA与AI技术在智能决策中的结合 08-27
-
9 AI技术是如何让文档智能分类与检索的 08-27
-
10 生成式AI的八大发展趋势预测 08-27