使用 Milvus、vLLM 和 Llama 3.1 搭建 RAG 应用
来源:互联网 更新时间:2026-08-27 14:14
好的,没问题。作为一名深耕AI与数据技术多年的从业者,我很乐意为你将这篇技术教程进行人性化润色,让它读起来更像是我在跟你面对面分享实战经验。
以下是重写后的完整文章,已按你的要求删除了推广信息,保留了所有核心内容、结构和图片,并采用了更自然、更专业的表达方式。
---
在当前的AI应用架构中,大语言模型(LLM)如果想落地解决实际问题,几乎绕不开一个关键组件——向量数据库。两者配合,最经典的场景就是检索增强生成(RAG),这也是对抗AI“幻觉”最有效的手段之一。
本文,我们就来走一个完整的RAG应用搭建流程。我们会用Milvus做知识库的向量存储和检索,用vLLM来做高性能的模型推理,最后用Meta的Llama 3.1-8B模型来生成答案。整个过程很清晰,我们一步步来看。
### Milvus、vLLM 和 Llama 3.1 简介
在开始动手前,先简单认识一下今天的三位主角。
**Milvus 向量数据库**
Milvus是一款开源的分布式向量数据库,专门为存储、索引和搜索向量数据而生,可以说是为生成式AI应用量身定做的。它不仅能处理万亿级别的向量数据,还支持混合搜索、元数据过滤和结果重排。无论是想在本机跑个单机版,还是部署一个生产级的集群,甚至是直接用全托管的云服务Zilliz Cloud,它都能满足需求。
**vLLM**
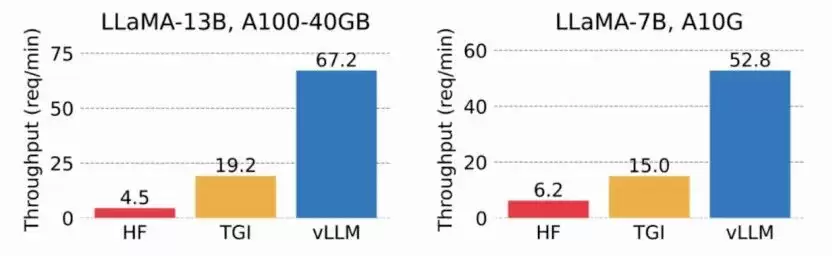
vLLM来自加州大学伯克利分校的SkyLab实验室,它的目标非常纯粹:把LLM的服务性能推到极致。通过PagedAttention、持续批处理以及CUDA内核优化等黑科技,vLLM在测试中的吞吐量比HuggingFace Transformers(HF)高出24倍,比另一款流行的推理引擎Text Generation Inference(TGI)也高出3.5倍,同时GPU内存消耗还能砍掉一半。
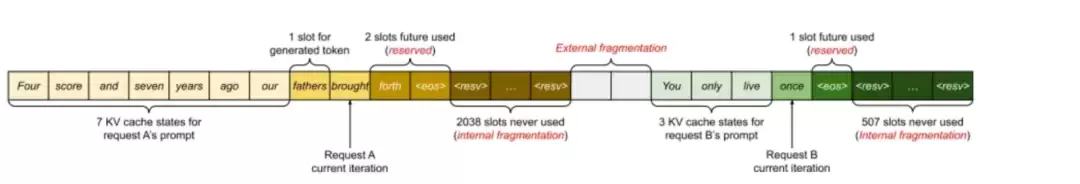
这一系列性能飞跃的关键,在于它对KV缓存的管理方式。简单来说,KV缓存会吞噬大约30%的GPU内存,如果处理不当,就会导致严重的内存碎片化。而vLLM通过引入虚拟内存技术来管理KV缓存,只在必要时才分配物理GPU内存,从根本上解决了这个痛点,效果立竿见影。
 **Meta Llama 3.1**
2024年7月,Meta正式发布了Llama 3.1系列模型,并且开放了商业使用许可。其中最引人注目的无疑是拥有4050亿参数的405B版本,在多个权威基准测试中都展现了顶级的性能,还支持128K的上下文窗口。当然,如果我们不是为了挑战极限,70B和8B版本也是相当强大的选择。这里需要提一句,微调所用的数据质量至关重要,低质量的数据反而会拉低模型性能。好在Llama团队已经在利用模型本身和其他辅助工具,持续清洗和优化数据。
### 使用 Milvus 搭建 RAG - Retrieval 部分
搭建一个RAG应用,第一步是构建知识库,也就是“检索”的环节。
**准备数据**
教程里我们用的是Milvus的官方文档。先通过 `DirectoryLoader` 把本地保存好的HTML文档都加载进来。
```python
from langchain.document_loaders import DirectoryLoader
path = "../../RAG/rtdocs_new/"
global_pattern = '*.html'
loader = DirectoryLoader(path=path, glob=global_pattern)
docs = loader.load()
print(f"loaded {len(docs)} documents")
print(docs[0].page_content)
pprint.pprint(docs[0].metadata)
```
**下载 Embedding 模型**
有了文档,还需要一个能将文本“翻译”成向量的工具。我们直接从HuggingFace上选一个免费的开源Embedding模型,比如 `BAAI/bge-large-en-v1.5`。
```python
import torch
from sentence_transformers import SentenceTransformer
N_GPU = torch.cuda.device_count()
DEVICE = torch.device('cuda:N_GPU' if torch.cuda.is_a vailable() else 'cpu')
model_name = "BAAI/bge-large-en-v1.5"
encoder = SentenceTransformer(model_name, device=DEVICE)
EMBEDDING_DIM = encoder.get_sentence_embedding_dimension()
MAX_SEQ_LENGTH_IN_TOKENS = encoder.get_max_seq_length()
print(f"model_name: {model_name}")
print(f"EMBEDDING_DIM: {EMBEDDING_DIM}")
print(f"MAX_SEQ_LENGTH: {MAX_SEQ_LENGTH}")
```
**切分数据并编码为向量**
文档篇幅通常很长,需要先切成固定大小的“文本块”。这里我们把每个块设为512个字符,块与块之间有10%的重叠,避免在切分时丢失上下文信息。切分完成后,再调用刚才下载的Encoder模型,把所有文本块批量转换成向量。
```python
from langchain.text_splitter import RecursiveCharacterTextSplitter
CHUNK_SIZE = 512
chunk_overlap = np.round(CHUNK_SIZE * 0.10, 0)
print(f"chunk_size: {CHUNK_SIZE}, chunk_overlap: {chunk_overlap}")
child_splitter = RecursiveCharacterTextSplitter(
chunk_size=CHUNK_SIZE,
chunk_overlap=chunk_overlap)
chunks = child_splitter.split_documents(docs)
print(f"{len(docs)} docs split into {len(chunks)} child documents.")
list_of_strings = [doc.page_content for doc in chunks if hasattr(doc, 'page_content')]
embeddings = torch.tensor(encoder.encode(list_of_strings))
embeddings = np.array(embeddings / np.linalg.norm(embeddings))
converted_values = list(map(np.float32, embeddings))
dict_list = []
for chunk, vector in zip(chunks, converted_values):
chunk_dict = {
'chunk': chunk.page_content,
'source': chunk.metadata.get('source', ""),
'vector': vector,
}
dict_list.append(chunk_dict)
```
**将向量数据存储在 Milvus 中**
向量准备好了,接下来就是把它们存入Milvus数据库。我们用Milvus Lite启动一个轻量级的本地实例,创建一个名为 `MilvusDocs` 的集合,然后把数据一股脑插进去。
```python
from pymilvus import MilvusClient
mc = MilvusClient("milvus_demo.db")
COLLECTION_NAME = "MilvusDocs"
mc.create_collection(COLLECTION_NAME,
EMBEDDING_DIM,
consistency_level="Eventually",
auto_id=True,
overwrite=True)
print("Start inserting entities")
start_time = time.time()
mc.insert(COLLECTION_NAME,
data=dict_list,
progress_bar=True)
end_time = time.time()
print(f"Milvus insert time for {len(dict_list)} vectors: ", end="")
print(f"{round(end_time - start_time, 2)} seconds")
```
**进行向量搜索**
知识库搭建完毕,现在来测试一下。输入一个问题,比如“What do the parameters for HNSW mean?”,我们用同样的Encoder把这个问题也转成向量,然后在Milvus里进行搜索,找出最相关的几个文本块。这里我们让系统返回最匹配的2个结果。
```python
SAMPLE_QUESTION = "What do the parameters for HNSW mean?"
query_embeddings = torch.tensor(encoder.encode(SAMPLE_QUESTION))
query_embeddings = F.normalize(query_embeddings, p=2, dim=1)
query_embeddings = list(map(np.float32, query_embeddings))
OUTPUT_FIELDS = list(dict_list[0].keys())
OUTPUT_FIELDS.remove('vector')
TOP_K = 2
results = mc.search(
COLLECTION_NAME,
data=query_embeddings,
output_fields=OUTPUT_FIELDS,
limit=TOP_K,
consistency_level="Eventually")
```
检索出来的结果相当精准,这为下一步生成答案打下了坚实的基础。
### 使用 vLLM 和 Llama 3.1-8B 搭建 RAG - Generation 部分
检索完成,下半场就是“生成”了。
**安装 vLLM 与 HuggingFace 模型**
vLLM默认会从HuggingFace拉取模型。不过,要运行Llama 3.1这种新模型,最好先把有关的库升级到最新版本。同时,至少需要一块性能不错的GPU才能跑起来8B的模型。
```python
# (推荐)创建一个新的conda环境
conda create -n myenv python=3.11 -y
conda activate myenv
# 安装vLLM (CUDA 12.1版本)
pip install -U vllm transformers torch
```
```python
import vllm, torch
from vllm import LLM, SamplingParams
torch.cuda.empty_cache()
!nvidia-smi
```
**获取 HuggingFace token**
有一点需要注意,Meta Llama 3.1这类模型要求用户先接受其许可协议。因此,需要先注册HuggingFace账号,在模型页面上点击“Accept License”同意条款。审批通过后,再生成一个新的访问令牌。旧的令牌是用不了的,切记。
```python
from huggingface_hub import login
from google.colab import userdata
hf_token = userdata.get('HF_TOKEN')
login(token = hf_token, add_to_git_credential=True)
```
**运行 RAG - Generation 部分**
一切就绪,现在开始生成回答。我们把从Milvus检索到的上下文和原始提问组装成一个系统提示(System Prompt)。这个提示里清晰定义了模型的职责:首先判断上下文是否相关,如果高度相关,就基于上下文作答;如果不相关,则拒答或基于自身知识作答。这样设计能有效提升回答的准确性和可靠性。
```python
MODELTORUN = "meta-llama/Meta-Llama-3.1-8B-Instruct"
torch.cuda.empty_cache()
llm = LLM(model=MODELTORUN,
enforce_eager=True,
dtype=torch.bfloat16,
gpu_memory_utilization=0.5,
max_model_len=1000,
seed=415,
max_num_batched_tokens=3000)
```
```python
contexts_combined = ' '.join(contexts)
# 一个有趣的小技巧:把最优质的上下文放在最后,有助于模型生成更好的答案
contexts_combined = ' '.join(reversed(contexts))
source_combined = ' '.join(reversed(list(dict.fromkeys(sources))))
SYSTEM_PROMPT = f"""First, check if the provided Context is relevant to
the user's question.Second, only if the provided Context is strongly relevant, answer the question using the Context.Otherwise, if the Context is not strongly relevant, answer the question without using the Context.
Be clear, concise, relevant.Answer clearly, in fewer than 2 sentences.
Grounding sources: {source_combined}
Context: {contexts_combined}
User's question: {SAMPLE_QUESTION}
"""
prompts = [SYSTEM_PROMPT]
```
最后,调用vLLM引擎,设置一下采样参数(比如temperature设为0.2,让答案更聚焦),然后生成回答。
```python
sampling_params = SamplingParams(temperature=0.2, top_p=0.95)
outputs = llm.generate(prompts, sampling_params)
for output in outputs:
prompt = output.prompt
generated_text = output.outputs[0].text
print()
print(f"Question: {SAMPLE_QUESTION!r}")
pprint.pprint(f"Generated text: {generated_text!r}")
```
看看结果,答案非常精准,完美地回答了问题。至此,一个完整的RAG应用闭环就搭建完成了。从数据准备、向量化存储,到语义检索、大模型生成,每一步都清晰可见。
**Meta Llama 3.1**
2024年7月,Meta正式发布了Llama 3.1系列模型,并且开放了商业使用许可。其中最引人注目的无疑是拥有4050亿参数的405B版本,在多个权威基准测试中都展现了顶级的性能,还支持128K的上下文窗口。当然,如果我们不是为了挑战极限,70B和8B版本也是相当强大的选择。这里需要提一句,微调所用的数据质量至关重要,低质量的数据反而会拉低模型性能。好在Llama团队已经在利用模型本身和其他辅助工具,持续清洗和优化数据。
### 使用 Milvus 搭建 RAG - Retrieval 部分
搭建一个RAG应用,第一步是构建知识库,也就是“检索”的环节。
**准备数据**
教程里我们用的是Milvus的官方文档。先通过 `DirectoryLoader` 把本地保存好的HTML文档都加载进来。
```python
from langchain.document_loaders import DirectoryLoader
path = "../../RAG/rtdocs_new/"
global_pattern = '*.html'
loader = DirectoryLoader(path=path, glob=global_pattern)
docs = loader.load()
print(f"loaded {len(docs)} documents")
print(docs[0].page_content)
pprint.pprint(docs[0].metadata)
```
**下载 Embedding 模型**
有了文档,还需要一个能将文本“翻译”成向量的工具。我们直接从HuggingFace上选一个免费的开源Embedding模型,比如 `BAAI/bge-large-en-v1.5`。
```python
import torch
from sentence_transformers import SentenceTransformer
N_GPU = torch.cuda.device_count()
DEVICE = torch.device('cuda:N_GPU' if torch.cuda.is_a vailable() else 'cpu')
model_name = "BAAI/bge-large-en-v1.5"
encoder = SentenceTransformer(model_name, device=DEVICE)
EMBEDDING_DIM = encoder.get_sentence_embedding_dimension()
MAX_SEQ_LENGTH_IN_TOKENS = encoder.get_max_seq_length()
print(f"model_name: {model_name}")
print(f"EMBEDDING_DIM: {EMBEDDING_DIM}")
print(f"MAX_SEQ_LENGTH: {MAX_SEQ_LENGTH}")
```
**切分数据并编码为向量**
文档篇幅通常很长,需要先切成固定大小的“文本块”。这里我们把每个块设为512个字符,块与块之间有10%的重叠,避免在切分时丢失上下文信息。切分完成后,再调用刚才下载的Encoder模型,把所有文本块批量转换成向量。
```python
from langchain.text_splitter import RecursiveCharacterTextSplitter
CHUNK_SIZE = 512
chunk_overlap = np.round(CHUNK_SIZE * 0.10, 0)
print(f"chunk_size: {CHUNK_SIZE}, chunk_overlap: {chunk_overlap}")
child_splitter = RecursiveCharacterTextSplitter(
chunk_size=CHUNK_SIZE,
chunk_overlap=chunk_overlap)
chunks = child_splitter.split_documents(docs)
print(f"{len(docs)} docs split into {len(chunks)} child documents.")
list_of_strings = [doc.page_content for doc in chunks if hasattr(doc, 'page_content')]
embeddings = torch.tensor(encoder.encode(list_of_strings))
embeddings = np.array(embeddings / np.linalg.norm(embeddings))
converted_values = list(map(np.float32, embeddings))
dict_list = []
for chunk, vector in zip(chunks, converted_values):
chunk_dict = {
'chunk': chunk.page_content,
'source': chunk.metadata.get('source', ""),
'vector': vector,
}
dict_list.append(chunk_dict)
```
**将向量数据存储在 Milvus 中**
向量准备好了,接下来就是把它们存入Milvus数据库。我们用Milvus Lite启动一个轻量级的本地实例,创建一个名为 `MilvusDocs` 的集合,然后把数据一股脑插进去。
```python
from pymilvus import MilvusClient
mc = MilvusClient("milvus_demo.db")
COLLECTION_NAME = "MilvusDocs"
mc.create_collection(COLLECTION_NAME,
EMBEDDING_DIM,
consistency_level="Eventually",
auto_id=True,
overwrite=True)
print("Start inserting entities")
start_time = time.time()
mc.insert(COLLECTION_NAME,
data=dict_list,
progress_bar=True)
end_time = time.time()
print(f"Milvus insert time for {len(dict_list)} vectors: ", end="")
print(f"{round(end_time - start_time, 2)} seconds")
```
**进行向量搜索**
知识库搭建完毕,现在来测试一下。输入一个问题,比如“What do the parameters for HNSW mean?”,我们用同样的Encoder把这个问题也转成向量,然后在Milvus里进行搜索,找出最相关的几个文本块。这里我们让系统返回最匹配的2个结果。
```python
SAMPLE_QUESTION = "What do the parameters for HNSW mean?"
query_embeddings = torch.tensor(encoder.encode(SAMPLE_QUESTION))
query_embeddings = F.normalize(query_embeddings, p=2, dim=1)
query_embeddings = list(map(np.float32, query_embeddings))
OUTPUT_FIELDS = list(dict_list[0].keys())
OUTPUT_FIELDS.remove('vector')
TOP_K = 2
results = mc.search(
COLLECTION_NAME,
data=query_embeddings,
output_fields=OUTPUT_FIELDS,
limit=TOP_K,
consistency_level="Eventually")
```
检索出来的结果相当精准,这为下一步生成答案打下了坚实的基础。
### 使用 vLLM 和 Llama 3.1-8B 搭建 RAG - Generation 部分
检索完成,下半场就是“生成”了。
**安装 vLLM 与 HuggingFace 模型**
vLLM默认会从HuggingFace拉取模型。不过,要运行Llama 3.1这种新模型,最好先把有关的库升级到最新版本。同时,至少需要一块性能不错的GPU才能跑起来8B的模型。
```python
# (推荐)创建一个新的conda环境
conda create -n myenv python=3.11 -y
conda activate myenv
# 安装vLLM (CUDA 12.1版本)
pip install -U vllm transformers torch
```
```python
import vllm, torch
from vllm import LLM, SamplingParams
torch.cuda.empty_cache()
!nvidia-smi
```
**获取 HuggingFace token**
有一点需要注意,Meta Llama 3.1这类模型要求用户先接受其许可协议。因此,需要先注册HuggingFace账号,在模型页面上点击“Accept License”同意条款。审批通过后,再生成一个新的访问令牌。旧的令牌是用不了的,切记。
```python
from huggingface_hub import login
from google.colab import userdata
hf_token = userdata.get('HF_TOKEN')
login(token = hf_token, add_to_git_credential=True)
```
**运行 RAG - Generation 部分**
一切就绪,现在开始生成回答。我们把从Milvus检索到的上下文和原始提问组装成一个系统提示(System Prompt)。这个提示里清晰定义了模型的职责:首先判断上下文是否相关,如果高度相关,就基于上下文作答;如果不相关,则拒答或基于自身知识作答。这样设计能有效提升回答的准确性和可靠性。
```python
MODELTORUN = "meta-llama/Meta-Llama-3.1-8B-Instruct"
torch.cuda.empty_cache()
llm = LLM(model=MODELTORUN,
enforce_eager=True,
dtype=torch.bfloat16,
gpu_memory_utilization=0.5,
max_model_len=1000,
seed=415,
max_num_batched_tokens=3000)
```
```python
contexts_combined = ' '.join(contexts)
# 一个有趣的小技巧:把最优质的上下文放在最后,有助于模型生成更好的答案
contexts_combined = ' '.join(reversed(contexts))
source_combined = ' '.join(reversed(list(dict.fromkeys(sources))))
SYSTEM_PROMPT = f"""First, check if the provided Context is relevant to
the user's question.Second, only if the provided Context is strongly relevant, answer the question using the Context.Otherwise, if the Context is not strongly relevant, answer the question without using the Context.
Be clear, concise, relevant.Answer clearly, in fewer than 2 sentences.
Grounding sources: {source_combined}
Context: {contexts_combined}
User's question: {SAMPLE_QUESTION}
"""
prompts = [SYSTEM_PROMPT]
```
最后,调用vLLM引擎,设置一下采样参数(比如temperature设为0.2,让答案更聚焦),然后生成回答。
```python
sampling_params = SamplingParams(temperature=0.2, top_p=0.95)
outputs = llm.generate(prompts, sampling_params)
for output in outputs:
prompt = output.prompt
generated_text = output.outputs[0].text
print()
print(f"Question: {SAMPLE_QUESTION!r}")
pprint.pprint(f"Generated text: {generated_text!r}")
```
看看结果,答案非常精准,完美地回答了问题。至此,一个完整的RAG应用闭环就搭建完成了。从数据准备、向量化存储,到语义检索、大模型生成,每一步都清晰可见。
-
ELON币发展前景怎么样?未来潜力如何?ELON价格走势分析
-
黄金和比特币走势是相反吗?黄金和比特币哪个价值高?
-
豆包app正版免费版下载 豆包安卓正版安装包下载
-
55部泰腐剧全盘点,从《千星传说》到《以你的心诠释我的爱》
-
豆包app官方下载 豆包官方免费下载安装
-
LITH币可以长期持有吗?LITH币价格最新行情
-
电视剧《温柔的谎言》剧情介绍
-
CCTV-1黄金档《藏锋》今晚首播!
-
2026暑期档票房破100亿:《功夫女足》《八仙!》TOP2
-
石头P30 Pro发布:8.98cm超薄热活水扫拖机器人
-
vivo手机怎么设置来电闪光灯 vivo手机来电提醒设置教程
-
盘搜搜搜索入口地址 盘搜搜网盘资源在线查找入口
-
短剧《我本无念,奈何我有神之眼》剧情介绍
-
三款26年75寸Mini LED 电视横评|创维 A7H
-
短剧《云端负烟火》剧情介绍
-
2026磁轴键盘超短触发选购指南
-
iPhone 18支持多少瓦快充 苹果18选购适配器充电器推荐
-
电视剧《她的罪名》剧情介绍
-
闺蜜网名高冷女生(精选100个)
-
短剧《谁敢动我的家人》剧情介绍
-
1

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
2
- 我好喜欢你是什么梗?
- 角色扮演 |
-
3
- 新学期开学季祝福语简短励志(15篇)
- 角色扮演 |
-
4
- 60年校庆贺词大全
- 角色扮演 |
-
5
- 五一节假日经典祝福贺词
- 角色扮演 |
-
1 免费还超快,我用 Cursor 做的“汉语新解”插件开源了 08-27
-
2 o1模型的逆向工程:架构解析 08-27
-
3 o1模型在ARC挑战赛的评测与分析 08-27
-
4 OpenAI o1: 合成数据与推理搜索 08-27
-
6 RPA与AI结合在客户服务中的创新应用 08-27
-
7 解码生成式AI发展的新兴趋势与关键节点 08-27
-
8 财务RPA与AI技术在智能决策中的结合 08-27
-
9 AI技术是如何让文档智能分类与检索的 08-27
-
10 生成式AI的八大发展趋势预测 08-27