忆联AM6B0 SSD为端侧AI大模型提速
来源:互联网 更新时间:2026-08-11 16:05
AI应用迎来集中爆发,也在倒逼终端硬件进入一轮全面升级。NVIDIA最新发布、采用统一内存(UMA)架构的RTX Spark超级芯片,已经让终端PC真正拥有了流畅运行千亿参数大模型的能力。但问题也恰恰在这里:从纸面上的超强算力,到实际可感知的落地体验,SSD始终是绕不过去的关键环节。无论是模型加载、版本切换,还是高频IO交互,背后都在持续考验存储的带宽、延迟与可靠性。在这样的背景下,AM6B0凭借满血性能、高可靠性以及与软硬件体系的深度协同,顺理成章地成为UMA时代大模型存储的“标配”之选。
实测验证
千亿大模型加载仅需14.6秒
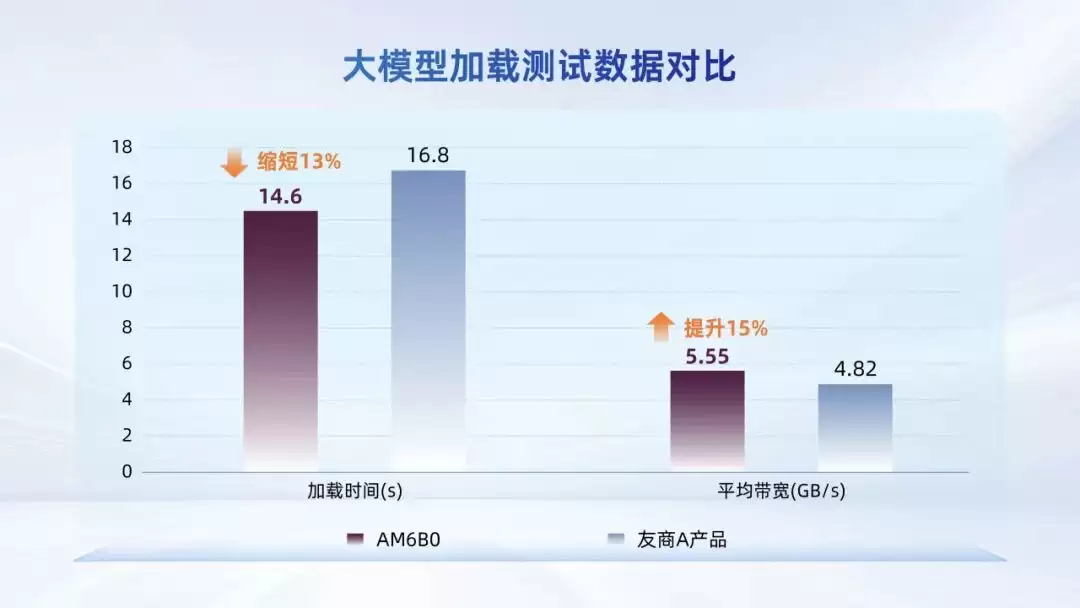
为验证AM6B0在AI场景下的真实性能,忆联测试团队基于搭载NVIDIA GB10芯片、128GB UMA内存及DGX OS(Ubuntu)的测试平台,对2TB容量的AM6B0产品进行了实测。结果显示,AM6B0冷启动加载Qwen3.5-122B大模型仅需14.6秒,平均读取带宽高达5.55GB/s。国内一线友商同级别产品加载耗时16.8秒,带宽仅4.82GB/s。AM6B0读取带宽领先约15%,加载时间缩短逾13%,差距显著。这一优势绝非微小增量,对于高频开展模型微调和推理测试的AI工程师而言,每一次加载的效率提升,将在日常反复操作中形成客观的规模效益,大幅削减无效等待时间,有效释放研发生产力,真正推动AI开发从“可用”迈向“高效”。
强劲性能
7.1GB/s满血释放PCIe 4.0潜能
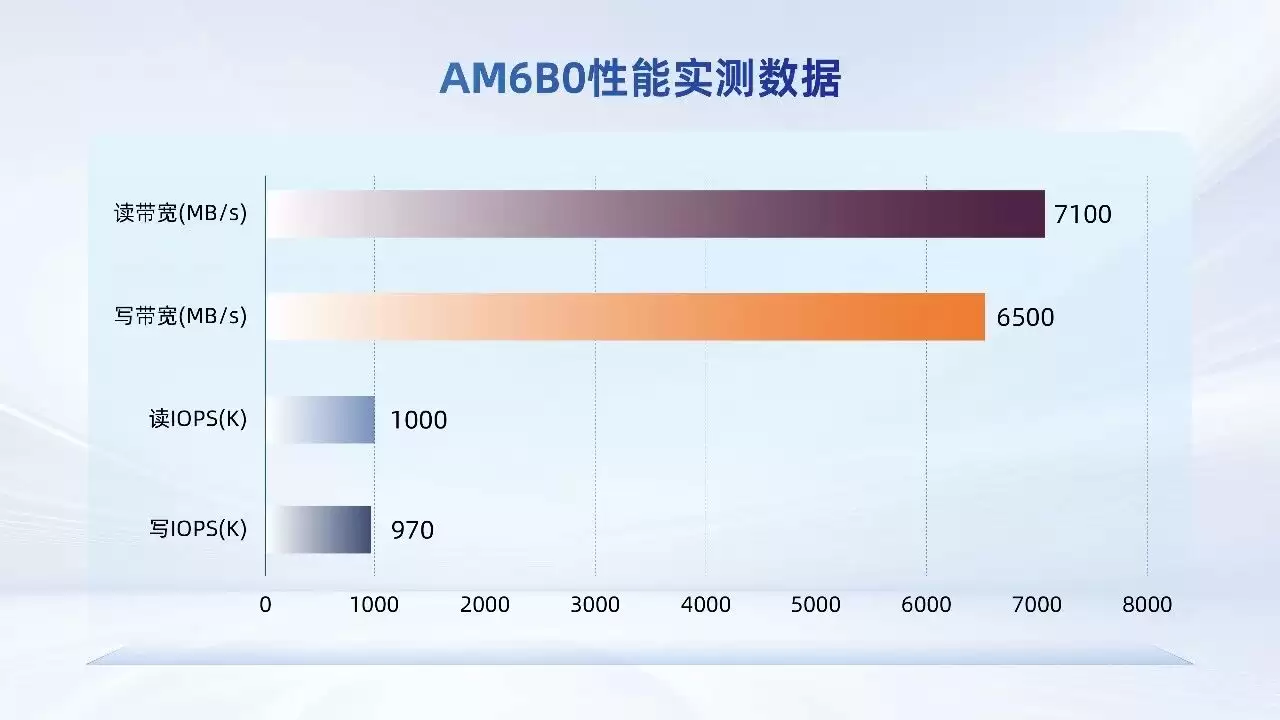
AM6B0配上了新一代主控和最新代际的闪存介质,几乎把PCIe 4.0的带宽上限吃得很透。放到CDM基准测试里看,它的2TB版本跑出了顺序读取7100MB/s、顺序写入6500MB/s,随机读取1000K IOPS、随机写入970K IOPS的成绩。换句话说,不管是大模型冷启动时的大体量加载,还是高频随机IO交互这种更考验响应的场景,AM6B0都能靠充足的带宽余量和很快的响应节奏稳稳接住,为AI开发这类重负载任务提供“即需即达”的存储支撑。
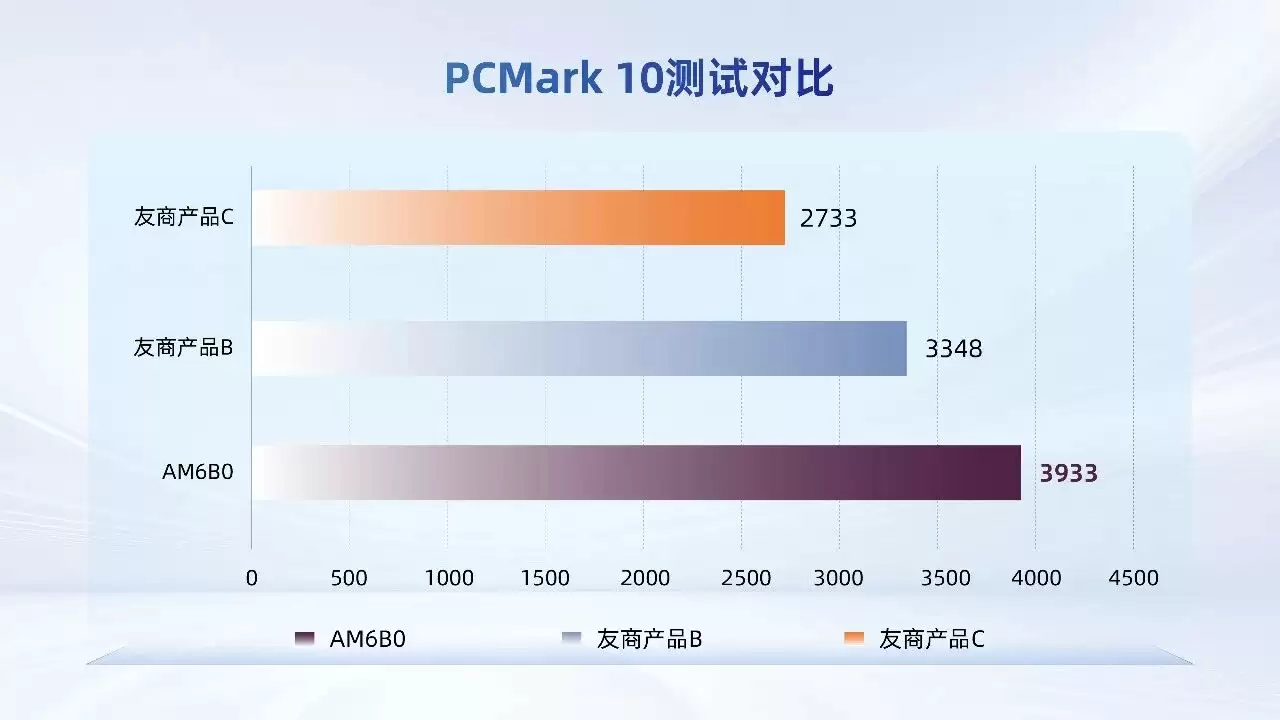
在PCMark 10基准测试中,AM6B0 2TB产品斩获3933分的优异成绩,全面领先同档次竞品。这一表现不仅印证了其在AI大模型加载与运行等重负载场景下的从容应对能力,更意味着系统启动、应用加载、日常办公等多元任务均可获得流畅高效的使用体验——从专业创作到日常交互,AM6B0以扎实的综合性能,为用户交付“全场景无短板”的存储体验。
安全可靠
全方位守护数字资产
除极致性能外,数据安全与稳定运行更是AI应用的生命线。AM6B0依托 Unbalance Die特性、WL Group Retry机制及精细化重试表策略,构建起从闪存纠错到耐久度强化、再到异常断电防护的多重保障体系——无论是大模型训练中断的突发风险,还是日常高频读写带来的累积损耗,均能从容应对,为每一项研发成果与数字资产筑起坚实防线。
AI浪潮风起云涌,忆联AM6B0以高效、可靠存力补齐算力落地的最后一公里,进一步优化大模型终端运行体验。面向未来,忆联将持续深耕AI终端存储赛道,以核心技术的不断迭代为驱动,打磨高性能、高可靠的存储解决方案,为AI开发者、内容创作者及高性能计算用户提供专业级生产力工具,持续助推终端AI生态加速升级。
-
职业小知识最新答案10.4
-
蚂蚁新村今日答案最新2026.9.30
-
蚂蚁庄园今日课堂答题2026年10月1日
-
2026年9月15日小鸡庄园答案
-
煤提质工这一职业诞生于哪种时代背景 蚂蚁新村今日答案2026.9.24
-
小鸡庄园今天答案2026.9.15
-
小鸡答题今天的答案是什么2026年9月20日
-
蚂蚁庄园小课堂2026年9月20日最新题目答案
-
2026年9月21日小鸡庄园答案
-
蚂蚁新村今日答案9.22
-
蚂蚁庄园答案2026年9月23日
-
有鸟有鸟群纸鸢因风假势童子牵描写的是什么场景 蚂蚁新村今日答案2026.9.29
-
以下哪一项是海水的主要运动形式
-
蚂蚁庄园小课堂今日最新答案2026年9月21日
-
小鸡庄园今天答案2026.9.23
-
跨经度最广的大洋是
-
蚂蚁庄园小鸡答题今日答案2026年9月30日
-
蚂蚁庄园今日课堂答题2026年9月30日
-
蚂蚁新村今日答案最新2026.9.29
-
2026年9月30日蚂蚁新村答案
-
1

- 20xx年男朋友生日祝福语大全【超有爱】
- 角色扮演 |
-
2
- 20xx年新人结婚祝福短信
- 角色扮演 |
-
3
- 关于小朋友生日祝福语大全
- 角色扮演 |
-
4
- 好哥们结婚祝福语搞怪
- 角色扮演 |
-
5
- 同事结婚祝福短信
- 角色扮演 |
-
1 大模型agent需要训练吗 08-21
-
2 多模态大模型agent 08-21
-
3 2026大模型电话机器人怎么选?正规靠谱技术服务公司要看这几点 08-22
-
4 火山引擎官网AI大模型入口_火山引擎方舟平台官方网页版地址 08-22
-
5 又蹭牛来!神秘大模型Ox Alpha匿名上线 08-22
-
6 中国大模型AI成斩杀线:美国AI依然领先一点 但没法赚大钱 08-22
-
8 什么是大模型 08-22
-
9 如何评估大模型的语言理解能力 08-22
-
10 推荐系统大模型是什么 08-22