OpenClaw多模型调度实战:智能路由策略与成本优化
来源:互联网 更新时间:2026-08-09 07:16
摘要
版本说明
openclaw.yaml 的通用配置范式与 Python 示例展开,底层思想(路由、降级、成本权衡)长期适用。涉及生产部署时,请以 OpenClaw GitHub 最新文档为准。
一、引言:为什么需要多模型调度?
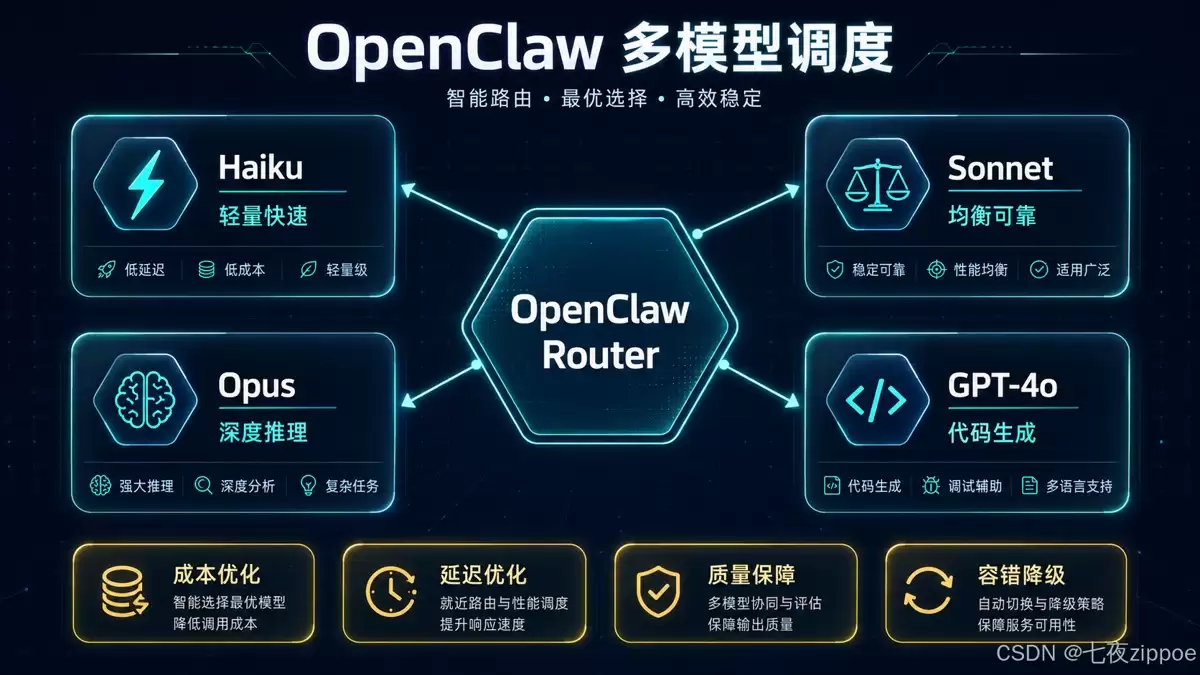
当你的 Agent 只用一个模型跑所有任务,就像用大锤钉钉子——能钉,但代价太大。实际业务中,任务复杂度的分布极度不均:大约七成的日常请求(格式转换、简单问答、模板填充)用轻量模型就能搞定,只有三成真正需要大模型出马。如果所有请求都走最强模型,这部分开销完全是浪费。
更麻烦的是,模型服务并非永远可用。API 限流、区域网络抖动、服务商临时故障都可能让单一模型配置瞬间"罢工"。没有降级路径的 Agent,在凌晨故障时只能让用户干等。多模型调度要解决的核心问题可以归纳为四点:
成本优化
延迟优化
质量保障
容错降级
OpenClaw 的多模型调度体系覆盖了从配置到决策、从执行到反馈的完整链路。与一些只提供统一 API 的框架不同,OpenClaw 把"模型选择"当作一等公民来对待:它不仅允许你声明多个模型,还支持规则、语义、成本、预算、熔断等多维度策略。这种设计让开发者可以在不修改业务代码的情况下,通过调整配置就完成路由策略的迭代。接下来我会先从核心概念讲起,再逐步展开配置、路由算法、降级策略与评估方法。
二、核心概念拆解
标题里的三个关键词——多模型调度、智能路由、OpenClaw——是理解全文的基础。下面逐一拆解。
2.1 多模型调度是什么
多模型调度(Multi-Model Orchestration)是指在 AI 应用的后端,根据请求特征、成本约束、延迟要求和可用性状态,动态选择最合适的模型来执行。它不是简单地把多个模型列出来,而是在它们之间做
有策略的分配
打个比方:医院分诊台会根据病人症状的轻重缓急决定挂哪个科室。多模型调度就是这个"分诊台",它判断当前任务是"感冒"还是"手术",然后决定让"社区医生"还是"三甲专家"来处理。这样做的好处显而易见:小病不占用专家资源,大病也能得到及时救治。
2.2 智能路由是什么
智能路由是多模型调度的"大脑",负责做具体的模型选择决策。它通常分为三个层次:
- :基于预定义的关键词、任务类型、token 长度等硬规则快速匹配。
规则路由
- :用轻量模型理解请求意图,再做分类。
语义路由
- :规则优先处理高置信度场景,语义模型覆盖灰色地带,默认模型兜底。
混合路由
三种模式各有优劣。规则路由快但死板,语义路由灵活但有额外开销,混合路由则在两者之间取得平衡,是生产环境最常见的选择。
2.3 OpenClaw 的调度体系定位
OpenClaw 把多模型调度内建为 Agent 基础设施,而不是让用户在每个 Skill 里重复写选择逻辑。它的核心层包括:
- :用
配置层
openclaw.yaml定义默认模型、覆盖规则、Fallback 链与权重。 - :规则路由器、语义分类器、成本感知调度器协同工作。
决策层
- :模型调用、超时控制、重试与熔断。
执行层
- :日志、指标、A/B 测试结果回流,持续优化路由策略。
反馈层
下面这张思维导图帮你建立全局认知:
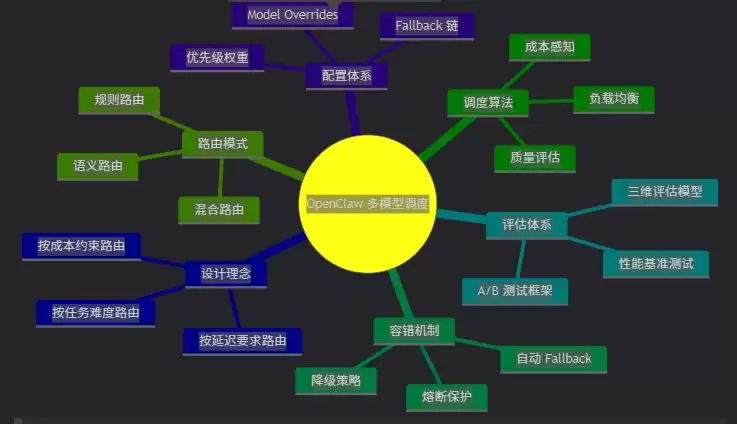
图2:OpenClaw 多模型调度体系思维导图,覆盖设计、配置、路由、容错与评估五大模块。
三、OpenClaw 模型配置体系
配置是调度的基础。OpenClaw 的模型配置不是"选一个模型"这么简单,而是一个分层的系统,支持默认模型、场景覆盖、Fallback 链和优先级权重。
3.1 模型分层配置
下面这份 YAML 把默认模型、覆盖规则、Fallback 链和权重策略放在一份配置里,便于理解它们如何协同:
# openclaw.yaml 模型配置示例
models:
  default: maas/astronclaw-auto      # 兜底默认模型
  overrides:
    code_generation:
      model: maas/gpt-4o
      temperature: 0.2
      max_tokens: 4096
    casual_chat:
      model: maas/claude-haiku
      temperature: 0.7
      max_tokens: 1024
    deep_reasoning:
      model: maas/claude-opus
      temperature: 0.3
      max_tokens: 8192
      thinking: stream
  fallback_chain:
    - model: maas/claude-opus
      timeout: 30000
    - model: maas/gpt-4o
      timeout: 20000
    - model: maas/claude-sonnet
      timeout: 15000
    - model: maas/claude-haiku
      timeout: 10000
  routing:
    strategy: weighted_priority
    candidates:
      - model: maas/claude-opus
        weight: 40
        priority: 1
        conditions:
          min_complexity: L2
      - model: maas/claude-sonnet
        weight: 35
        priority: 2
        conditions:
          min_complexity: L1
      - model: maas/claude-haiku
        weight: 25
        priority: 3
        conditions:
          max_complexity: L1
代码解释(100 字+)
overrides 根据场景直接覆盖默认模型,例如代码生成走 GPT-4o、闲聊走 Haiku;fallback_chain 定义了模型不可用时从高到低的安全降级路径;routing 则用权重与条件决定多候选模型之间的流量分配。预期效果是:常规请求走最匹配的模型,故障时自动降级,预算紧张时还能通过权重切流量。
3.2 任务难度分级
调度系统需要一个统一的语言描述任务复杂度。OpenClaw 通常把任务分为 L0–L3 四个层级:
| 难度层级 | 典型任务 | 推荐模型规格 | 预估成本倍数 |
|---|---|---|---|
| L0-简单 | 格式转换、关键词提取、模板填充 | 轻量模型(如 Haiku) | 1x |
| L1-常规 | 日常对话、文档摘要、简单问答 | 中等模型(如 Sonnet) | 3-5x |
| L2-复杂 | 代码生成、多步推理、创意写作 | 强力模型(如 GPT-4o) | 10-15x |
| L3-极难 | 数学证明、架构设计、长链推理 | 旗舰模型(如 Opus) | 30-50x |
注意成本倍数是相对值。如果你 70% 的请求都是 L0,用轻量模型跑这部分,整体成本可能降到原来的五分之一甚至更低。关键不是每个任务都用最强模型,而是让"合适的任务找到合适的模型"。
四、路由器设计模式
路由器决定每个请求该发给哪个模型。OpenClaw 支持规则、语义、混合三种模式,下面给出可直接落地的实现。
4.1 规则路由与语义路由的取舍
规则路由基于关键词、token 长度、任务标签等硬条件匹配,优点是快、可解释、零额外模型开销;缺点是对语义理解有限,容易把"帮我看看这段代码有没有 bug"误判为必须用 GPT-4o 的代码任务,其实它只是一个轻量审查请求。
语义路由则用轻量模型做一次意图分类,能够理解上下文和隐含需求,更灵活;代价是多一次分类调用(通常几十毫秒、几分钱)。
4.2 混合路由实现
生产环境中,最好的方案是把两者结合起来:规则先做快速筛选,规则覆盖不到的场景再走语义分类。下面是一个精简的混合路由器实现:
import re
from dataclasses import dataclass
from typing import List, Tuple
@dataclass
class RouteRule:
    pattern: str
    model: str
    priority: int
class HybridRouter:
    """混合路由:规则优先,语义兜底"""
    RULES = [
        RouteRule(r"(代码|编程|debug|function)", "maas/gpt-4o", 1),
        RouteRule(r"(数学|证明|方程|algorithm)", "maas/claude-opus", 1),
        RouteRule(r"(写|创作|故事|创意)", "maas/claude-sonnet", 2),
        RouteRule(r"bw{50,}b", "maas/gemini-pro", 3),  # 长上下文
    ]
    SEMANTIC_MAP = {
        "simple_qa": "maas/claude-haiku",
        "moderate_task": "maas/claude-sonnet",
        "complex_reasoning": "maas/claude-opus",
    }
    def __init__(self, classifier=None):
        self.classifier = classifier  # 轻量分类模型
    def route(self, task: dict) -> str:
        content = task.get("content", "")
        # 第一层:规则匹配
        matched = [(r.priority, r.model) for r in self.RULES
                   if re.search(r.pattern, content, re.I)]
        if matched:
            return min(matched, key=lambda x: x[0])[1]
        # 第二层:语义分类
        if self.classifier:
            intent = self._classify(content)
            return self.SEMANTIC_MAP.get(intent, "maas/claude-sonnet")
        # 兜底
        return "maas/claude-sonnet"
    def _classify(self, content: str) -> str:
        prompt = f"判断意图(simple_qa/moderate_task/complex_reasoning):n{content}n只输出意图名。"
        return self.classifier(prompt).strip().lower()
代码解释(100 字+)
五、成本感知调度算法
路由模式解决"按什么规则选模型",调度算法解决"如何在多个候选中做最优选择"。成本感知调度的核心目标是:
在满足质量要求的前提下,最小化总体成本
5.1 任务复杂度评估
调度的前提是知道任务有多难。OpenClaw 用多维度特征加权评估复杂度:
| 特征维度 | 指标 | 权重 | 说明 |
|---|---|---|---|
| 输入长度 | token 数 | 0.15 | 越长越可能复杂 |
| 输出预期 | 预估输出 token | 0.10 | 长输出通常更难 |
| 推理深度 | 是否含推理关键词 | 0.30 | 推理是复杂度最关键指标 |
| 知识领域 | 专业领域标记 | 0.20 | 医疗/法律/金融等高壁垒领域 |
| 多步需求 | 子任务数量 | 0.15 | 需要拆解的任务更难 |
| 交互轮次 | 对话历史长度 | 0.10 | 上下文越多约束越复杂 |
加权得分映射到 L0–L3 层级后,调度器就知道该在哪个难度区间挑选模型。这个评估本身用轻量模型就能完成,开销几乎可以忽略。
5.2 成本感知选择器
有了复杂度评估,下一步是计算每个候选模型的"性价比"。下面是一个精简的成本感知调度器:
class CostAwareScheduler:
    """在满足质量阈值的前提下,选择性价比最高的模型"""
    QUALITY = {
        "haiku":  {"L0": 0.92, "L1": 0.78, "L2": 0.55, "L3": 0.30},
        "sonnet": {"L0": 0.97, "L1": 0.93, "L2": 0.82, "L3": 0.65},
        "opus":   {"L0": 0.99, "L1": 0.98, "L2": 0.95, "L3": 0.92},
    }
    COST = {"haiku": 0.25, "sonnet": 3.0, "opus": 15.0}
    def select(self, level: str, quality_threshold: float = 0.8,
               budget_mode: str = "balanced") -> str:
        candidates = []
        for model, qual in self.QUALITY.items():
            q = qual[level]
            if q < quality_threshold:
                continue
            # 预算紧张时,成本权重提升
            cost = self.COST[model]
            weight = 2.0 if budget_mode == "cost_saving" else 1.0
            utility = q / (cost ** weight)
            candidates.append((utility, model, q, cost))
        if not candidates:
            return max(self.QUALITY,
                       key=lambda m: self.QUALITY[m][level])
        candidates.sort(reverse=True)
        return candidates[0][1]
代码解释(100 字+)
level、质量阈值 quality_threshold 和预算模式 budget_mode。它会先排除质量不达标的模型,然后在剩余候选中按"质量/成本^权重"计算效用并排序。预算紧张时成本权重提高,系统会更倾向便宜模型。预期效果是:L1 任务如果 Haiku 质量不达标(0.78 < 0.8),会自动选择 Sonnet 而非昂贵的 Opus。
5.3 动态预算控制
单个请求的优化还不够,整体预算管控才能让系统长期稳定。OpenClaw 通常按日/周/月设置预算上限,并根据消耗比例自动切换路由模式。这个思路很像手机电量管理:电量充足时性能全开,电量低于 20% 时自动开启省电模式,核心功能继续运行,但非必要特效全部关闭。
落到具体执行层面,预算控制器会持续记录一笔“已消耗金额”,并据此计算 ratio = spent / budget。当 ratio 低于 50% 时,系统会进入“质量优先”模式:L1 及以上任务都能分配给 Sonnet 或 Opus,核心目标很明确,就是尽可能把输出质量拉满;当 ratio 超过 50% 但还没到 80% 时,策略会切到“均衡模式”,这时候 L1 任务开始交给 Haiku,L2 继续使用 Sonnet,只有 L3 保留给 Opus;如果 ratio 超过 80%,系统就会转入“成本节省”模式”,L0-L2 全部改走 Haiku,只有 L3 才继续使用 Sonnet;而一旦 ratio 突破 95%,就会触发“紧急模式”,所有任务都会优先选择最便宜的模型,目的只有一个:保证服务不会因为预算见底而直接停摆。
这种分层控制的关键在于平滑过渡。如果阈值设置得太密集,路由策略会频繁切换,导致输出质量忽高忽低;如果阈值太稀疏,又会在预算耗尽前没有足够缓冲。50%、80%、95% 是经验值,可以根据业务节奏调整。例如月末预算紧张的场景,可以把 95% 阈值提前到 90%,给用户更多缓冲。
预算控制还要和成本感知调度器联动。调度器负责单个请求的"性价比最优",预算控制器负责全局的"策略方向"。两者结合,才能实现从微观到宏观的一体化成本管理。需要特别注意的是,预算紧张时的降级必须可观测——每次策略切换都应该记录日志并发出通知,让运维人员知道当前系统正在"节衣缩食",而不是默默降低服务质量。
六、故障切换与降级策略
模型服务不是铁板一块,API 故障、限流、区域网络问题随时可能发生。成熟的调度系统必须能优雅处理这些情况。
6.1 自动 Fallback 机制
Fallback 的核心逻辑是"请求失败不报错,而是自动尝试下一个可用模型"。下面的时序图展示了一次典型的链式降级:
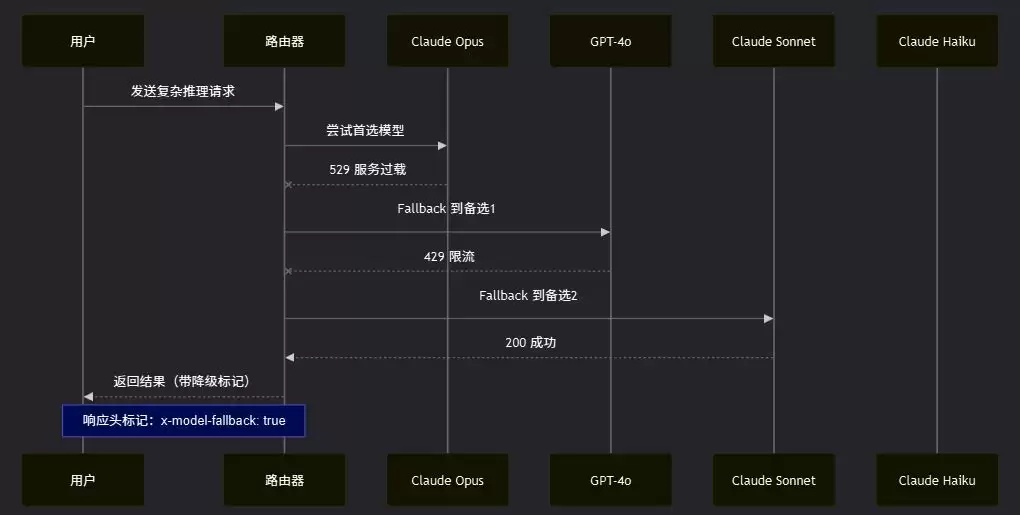
图4:Fallback 链式降级时序,首选模型失败依次尝试备选,成功后返回降级标记。
关键设计点包括:每个模型独立超时、失败记录用于健康检查、返回结果附带降级标记、降级后触发额外质量评估。
6.2 熔断保护
如果某个模型连续失败,继续尝试只会浪费时间。熔断器模式会在连续失败达到阈值后暂时"断开"该模型,避免无效请求:
import time
from dataclasses import dataclass, field

@dataclass
class CircuitState:
    status: str = "closed"
    failures: int = 0
    last_failure: float = 0.0

class ModelCircuitBreaker:
    """模型熔断器:连续失败后暂时跳过该模型"""

    def __init__(self, threshold: int = 3, recovery: int = 300):
        self.threshold = threshold
        self.recovery = recovery
        self.states: dict[str, CircuitState] = {}

    def can_use(self, model: str) -> bool:
        state = self.states.get(model)
        if not state or state.status == "closed":
            return True
        if state.status == "open":
            if time.time() - state.last_failure > self.recovery:
                state.status = "half_open"
                return True
            return False
        return True  # half_open

    def record(self, model: str, success: bool):
        state = self.states.setdefault(model, CircuitState())
        if success:
            state.status = "closed"
            state.failures = 0
        else:
            state.failures += 1
            state.last_failure = time.time()
            if state.failures >= self.threshold:
                state.status = "open"
代码解释(100 字+)
6.3 降级策略矩阵
降级不只是"换一个模型",有时还要"换策略"。下面这张表总结了不同场景的降级思路:
| 场景 | 首选模型不可用 | 降级策略 | 用户体验影响 |
|---|---|---|---|
| 日常对话 | Sonnet | → Haiku,降低创意性 | 轻微,回答可能更模板化 |
| 代码生成 | GPT-4o | → Sonnet + 代码校验 | 中等,需二次验证 |
| 深度推理 | Opus | → Sonnet + 思维链拆解 | 较大,推理深度受限 |
| 长文本分析 | Gemini Pro | → Sonnet + 分段处理 | 中等,需额外分块 |
| 实时对话 | Opus | → Haiku(优先延迟) | 轻微,响应更快但更浅 |
例如深度推理从 Opus 降到 Sonnet 时,不应直接复用同一 prompt,而应把问题拆成更小的子任务,用思维链逐步推导,弥补模型能力差距。
七、模型性能基准测试
调度决策不能靠直觉,必须建立在数据之上。基准测试是多模型调度的"情报系统"。
7.1 三维评估模型
OpenClaw 通常从延迟、成本、质量三个维度评估模型:
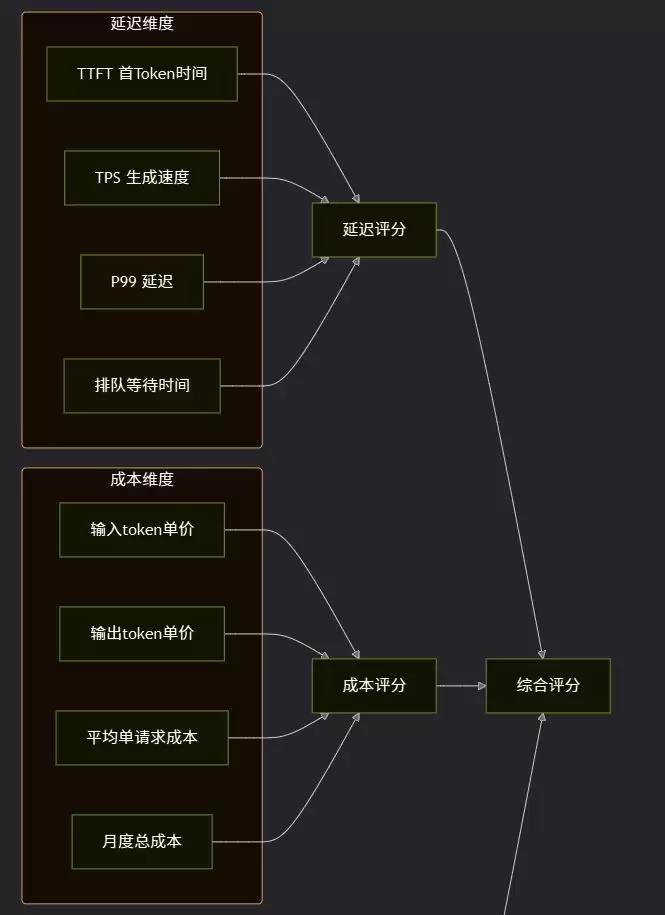
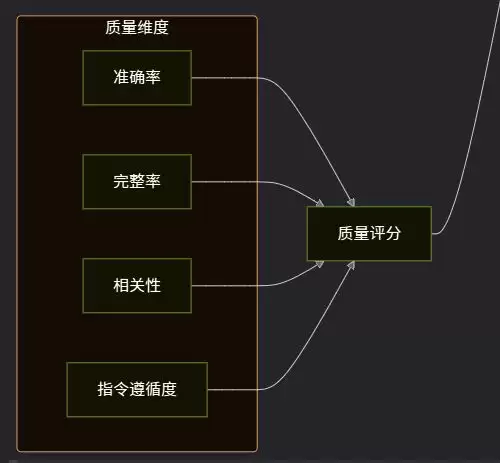
图5:模型三维评估框架,延迟、成本、质量分别聚合后形成综合评分。
7.2 基准测试结果示例
下面是一组典型结果:
| 指标 | Haiku | Sonnet | Opus | GPT-4o |
|---|---|---|---|---|
| TTFT (ms) | 180 | 350 | 800 | 420 |
| TPS (tokens/s) | 120 | 80 | 45 | 65 |
| P99 延迟 (s) | 1.2 | 2.8 | 6.5 | 3.5 |
| 单请求成本 ($) | 0.002 | 0.015 | 0.08 | 0.025 |
| L0 准确率 | 0.91 | 0.96 | 0.98 | 0.95 |
| L1 准确率 | 0.78 | 0.92 | 0.97 | 0.90 |
| L2 准确率 | 0.55 | 0.80 | 0.94 | 0.82 |
| L3 准确率 | 0.30 | 0.62 | 0.91 | 0.68 |
数据会说话:Haiku 在 L0 任务上准确率 0.91,只比 Opus 低 7 个百分点,但成本只有 1/40。如果 70% 请求都是 L0,用 Haiku 跑这部分能省下巨量成本,而质量损失几乎感知不到。
八、多模型 A/B 测试框架
调度策略不是一次定终身。随着模型更新、业务变化,你需要持续验证路由效果。A/B 测试是优化的基础设施。
8.1 A/B 测试实现
import time
import hashlib
from collections import defaultdict
class ModelABTest:
    """多模型 A/B 测试:按用户 ID 确定性分流"""
    def __init__(self, name: str, variants: dict):
        self.name = name
        self.variants = variants
        self.results = defaultdict(list)
    def assign(self, user_id: str) -> str:
        digest = hashlib.sha256(
            f"{self.name}:{user_id}".encode()
        ).hexdigest()
        ratio = int(digest[:8], 16) / 0xFFFFFFFF
        cumulative = 0.0
        for name, cfg in self.variants.items():
            cumulative += cfg["ratio"]
            if ratio <= cumulative:
                return name
        return list(self.variants.keys())[0]
    def record(self, variant: str, metrics: dict):
        self.results[variant].append({
            "timestamp": time.time(),
            "latency_ms": metrics.get("latency_ms"),
            "cost_usd": metrics.get("cost_usd"),
            "quality": metrics.get("quality_score"),
            "success": metrics.get("success", True),
        })
    def analyze(self) -> dict:
        report = {}
        for variant, data in self.results.items():
            if not data:
                continue
            lat = [d["latency_ms"] for d in data if d["latency_ms"]]
            cost = [d["cost_usd"] for d in data if d["cost_usd"]]
            qual = [d["quality"] for d in data if d["quality"]]
            report[variant] = {
                "model": self.variants[variant]["model"],
                "samples": len(data),
                "avg_latency_ms": sum(lat) / len(lat) if lat else 0,
                "avg_cost": sum(cost) / len(cost) if cost else 0,
                "avg_quality": sum(qual) / len(qual) if qual else 0,
                "success_rate": sum(d["success"] for d in data) / len(data),
            }
        return report
代码解释(100 字+)
ModelABTest 的输入是测试名称、分流变体配置与用户 ID,输出是用户被分配的实验组。它通过 SHA-256 哈希实现确定性分流,保证同一用户始终进入同一组,避免体验割裂。record 记录每次调用的延迟、成本、质量与成功率,analyze 汇总各组指标。预期效果是让你用数据判断哪个模型或路由策略在真实流量下更优。
8.2 A/B 测试结果解读要点
A/B 测试最怕数据误读。常见陷阱包括:样本量不足(每组至少 1000 次请求才有统计意义)、新奇效应、分流不均、辛普森悖论。建议先看总体指标,再按任务类型拆分,最后做统计显著性检验(t-test 或 Mann-Whitney U test),确认差异不是随机波动。
九、实战:构建完整的智能路由系统
把前面所有模块串起来,就得到 OpenClaw 生产级路由的完整架构:
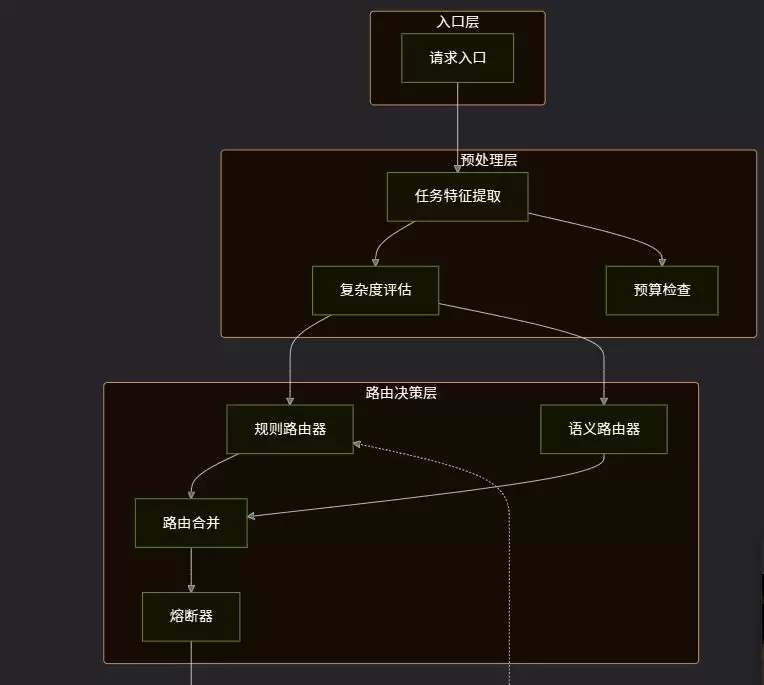
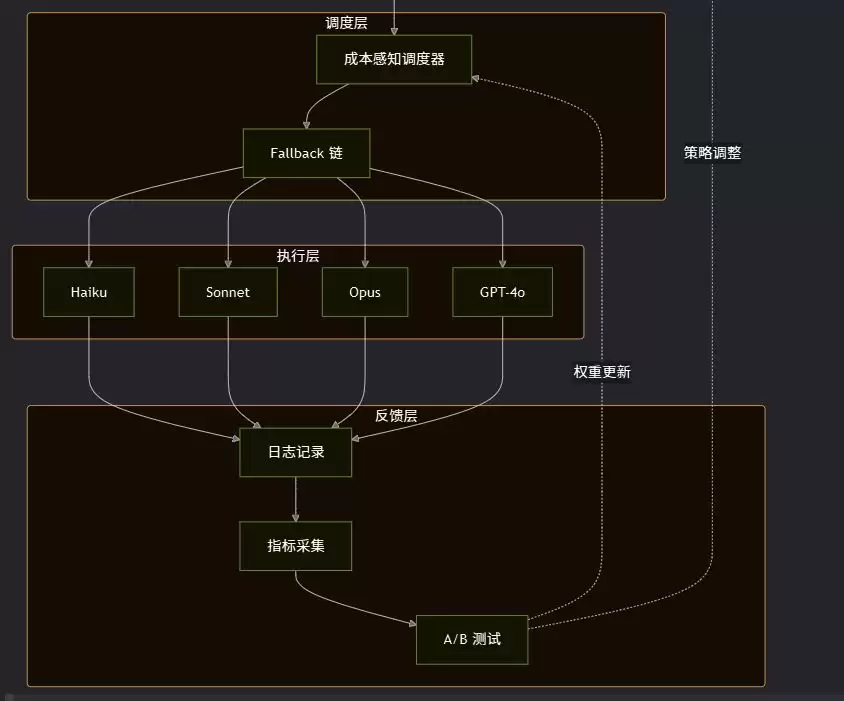
图6:OpenClaw 智能路由完整架构,从请求入口到反馈闭环形成五层处理链路。
9.1 配置最佳实践
基于生产经验,总结几条关键实践:
- :首选、备选、兜底,确保至少有两个降级选择。
Fallback 链至少三层
- :3 次连续失败触发,避免反复浪费请求。
熔断阈值不要太高
- :高峰期可放宽,低谷期收紧。
预算分时段控制
- :分类本身不该成为性能瓶颈。
语义分类用最轻的模型
- :模型在更新,评估数据也要跟着更新。
定期更新质量矩阵
9.2 常见坑与排障
| 问题 | 症状 | 排查方向 |
|---|---|---|
| 路由抖动 | 同类型请求反复切换模型 | 检查规则优先级和语义分类稳定性 |
| Fallback 风暴 | 大量请求触发降级 | 检查首选模型健康状态和熔断阈值 |
| 成本超标 | 预算消耗远超预期 | 检查是否有复杂度误判导致简单任务走大模型 |
| 延迟飙升 | 响应时间明显变慢 | 检查 Fallback 链是否过长,每次降级都增加延迟 |
| 质量下降 | 用户投诉回答质量变差 | 检查是否预算模式下过度降级 |
9.3 适用边界与替代方案
多模型调度确实能带来不少优势,但关键在于判断是否“值得”。如果你的 Agent 每天仅处理几十次调用,或者任务高度同质化——比如专注于代码审查——那么搭建复杂路由系统的边际收益其实微乎其微。在这种情况下,与其追求复杂,不如务实一些:选定一个最契合的单一模型,辅以简单的 Fallback 机制,往往能更高效地解决问题。
如果你暂时不用 OpenClaw,也可以基于本文的思路自建最小化路由层。核心只需要三个组件:一个规则匹配器(正则或关键词)、一个成本矩阵、一个 Fallback 函数。用几十行 Python 就能搭出一个可用的原型。等调用量上来、场景复杂起来之后,再逐步引入语义分类、预算控制和 A/B 测试。这种"先简单后复杂"的演进路径,比一开始就追求大而全更可控。
十、总结与展望
多模型调度不是锦上添花,而是生产级 AI Agent 的必备基础设施。从最简单的 Fallback 链到复杂的混合路由,从规则驱动到语义理解,从单次决策到全局预算优化——OpenClaw 提供了完整的调度工具链。
核心收获可以总结为五点:第一,
分层路由
成本感知
故障降级
基准测试
A/B 测试
未来,多模型调度还有几个值得关注的方向:基于强化学习的自适应路由、跨模态任务的模型编排、端侧模型与云端模型的混合调度。这些方向都在快速发展,将成为下一代 Agent 系统的重要能力。
-
斋醮音乐指的是哪一种音乐形式 蚂蚁新村今日答案2026.9.13
-
2026年9月15日小鸡庄园答案
-
蚂蚁庄园今日答案2026年9月9日
-
2026年9月21日小鸡庄园答案
-
宋词名句“欲买桂花同载酒”下一句是什么 蚂蚁庄园今日答案9.3
-
支付宝疯狂碰友节这是红箭答案
-
2026年9月13日小鸡庄园答案
-
蚂蚁庄园今日课堂答题2026年9月13日
-
蚂蚁庄园答案2026年9月13日
-
小鸡庄园今天答案2026.9.15
-
小鸡答题今天的答案是什么2026年9月2日
-
蚂蚁庄园小课堂2026年9月3日最新题目答案
-
比海底更深的“超深渊带”是指水深超过多少米
-
支付宝疯狂碰友节这是小提琴答案
-
支付宝疯狂碰友节这是菠萝答案
-
2026年9月9日小鸡庄园答案
-
蚂蚁庄园小鸡答题今日答案2026年9月12日
-
蚂蚁庄园今日答案2026年9月13日
-
小鸡庄园今天答案2026.9.13
-
蚂蚁新村2026年9月13日答案最新
-
1

- 20xx年男朋友生日祝福语大全【超有爱】
- 角色扮演 |
-
2
- 小萝莉美女柳侑绮h头像图片
- 角色扮演 |
-
3
- 20xx年新人结婚祝福短信
- 角色扮演 |
-
4
- 关于小朋友生日祝福语大全
- 角色扮演 |
-
5
- 好看的文艺青年男生带字头像
- 角色扮演 |
-
1 OpenClaw如何原生适配Windows 08-02
-
2 OpenClaw端口冲突怎么避免再次出现? 08-02
-
3 OpenClaw调用MCP工具怎么操作? 08-02
-
5 OpenClaw怎么通过Slack调用工具? 08-03
-
10 使用OpenClaw Browser实现表单自动化的方法 08-05