Gemini 3.6 Flash:谷歌DeepMind推出的新一代高效多模态大模型
来源:互联网 更新时间:2026-07-23 12:52
一、Gemini 3.6 Flash是什么
先说几个关键点:Gemini 3.6 Flash,简单来说,就是Google DeepMind最新出品的通用高效多模态大模型。这次它和Gemini 3.5 Flash-Lite、Gemini 3.5 Flash Cyber是同步上线的,三款一起亮相。官方的定位很明确,就是企业级通用主力推理模型,用来替代上一代的Gemini 3.5 Flash,扛起大规模生产环境中的AI任务。
这次的迭代,完全是基于开发者与企业客户对3.5 Flash的反馈来做的——说白了,就是大家觉得哪儿不好用,谷歌就改哪儿。核心升级主要围绕四个维度展开:Token使用效率、代码能力、多模态长文件处理,以及推理成本。既兼顾了极速响应速度,又保留了百万级超长上下文,还把商用定价压得更低了。面向个人开发者、中小企业、政企智能体项目,可以说,这是谷歌目前性价比最高的商用通用推理模型。
五、使用方法
方式1:网页端免费快速体验(个人用户)
如果你只是想试试水,最简单的办法就是登录谷歌Gemini网页客户端。系统默认就会调用3.6 Flash来处理你的日常问答、文案写作、图片解析等任务。谷歌账号每天都有免费调用额度,完全不需要申请API密钥,开箱即用。
方式2:Google AI Studio(开发者调试首选)
如果你是开发者,想先调试一下,那Google AI Studio是最方便的入口:
打开Google AI Studio官网,登录你的谷歌账号;
在模型下拉菜单里,直接选择
gemini-3.6-flash;接下来就可以在线对话调试了,上传图片、PDF、视频,测试它的多模态能力;
调试完成后,还能一键生成Python、Curl的调用代码,而且免费额度足够用于前期项目测试。
方式3:API商用接入(企业生产环境)
到了企业级生产环境,就需要走正式的API接入流程了:
先在Google AI Studio申请一个专属的API Key;
接口基础地址是
generativelanguage.googleapis.com/v1beta;请求头部要携带
x-goog-api-key密钥,并且指定model字段为gemini-3.6-flash;支持Python、Node.js、Curl等多语言调用,流式调用和异步批量任务都没问题;
如果企业规模比较大,还可以升级到Google Cloud Vertex AI,获得企业级的权限控制和流量管理。
方式4:IDE内置工具使用
对于开发者来说,还有一个更省事的办法:Android Studio、Google Antigra vity多智能体开发IDE已经原生集成了3.6 Flash。你不需要单独配置API,直接在IDE里就能完成代码补全、项目解析等操作,非常方便。
六、竞品对比
为了让大家更直观地了解它的实力,我们拿市场上主流的两个高效商用模型——GPT-4o Mini和Claude 3 Haiku——来做个横向对比。直接看下面的对比表,会更直观。
| 对比维度 | Gemini 3.6 Flash | GPT-4o Mini | Claude 3 Haiku |
|---|---|---|---|
| 最大输入上下文 | 104.8万Token | 12.8万Token | 20万Token |
| 单次最大输出 | 65536 Token | 16384 Token | 20000 Token |
| 百万Token输出定价 | 7.5美元 | 0.6美元 | 3美元 |
| 原生视频长视频支持 | 支持45分钟长视频 | 仅短视频片段 | 不支持视频输入 |
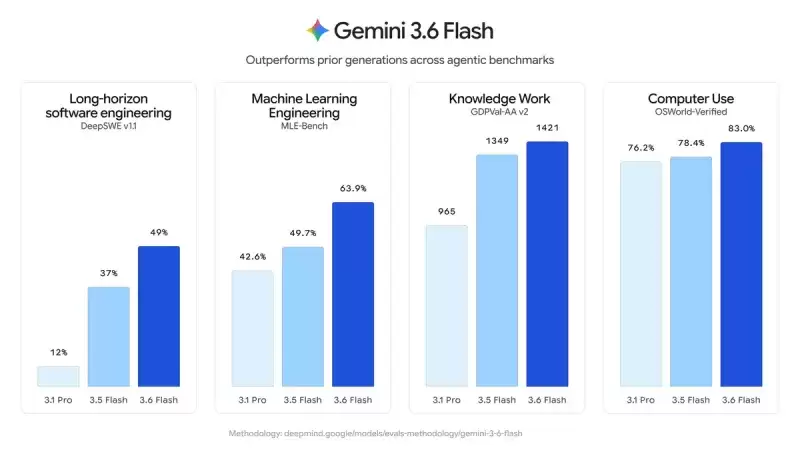
| 代码基准DeepSWE得分 | 49% | 41% | 39% |
| 桌面自动化Agent能力 | 原生内置 | 需插件扩展 | 无原生支持 |
| 知识库截止时间 | 2026年3月 | 2025年底 | 2025年底 |
| 核心优势 | 超长上下文、长视频、低成本长任务 | 单次调用单价极低 | 文本长对话逻辑细腻 |
| 短板 | 短高频问答单价高于竞品 | 上下文短、无原生长视频 | 不支持音视频多模态 |
从这张表里,基本能看出各家产品的取舍逻辑。Gemini 3.6 Flash在长上下文、长视频处理上优势明显,但如果你只是做大量的短问答,它的单价反而比GPT-4o Mini要高一些。没有完美的模型,关键看你的场景。
七、常见问题解答(FAQ)
Q1:Gemini 3.6 Flash和前代Gemini 3.5 Flash核心区别是什么?
核心升级有三点:第一,输出Token消耗量平均降低17%,代码任务最高能省65%的Token;第二,输出定价从9美元降到了7.5美元/百万Token;第三,代码和桌面自动化基准测试的分数大幅提升,工具调用次数更少,同等任务下综合调用成本下降了20%以上。
Q2:个人用户是否可以免费使用Gemini 3.6 Flash?
当然可以。谷歌Gemini网页客户端和Google AI Studio都提供免费每日调用额度。基础问答、图片解析、短代码调试,这些完全零成本。只有企业大规模商用,或者超出免费额度后,才会按Token计费。
Q3:Gemini 3.6 Flash支持本地私有化部署吗?
目前不支持独立本地私有化部署,只能通过云端API调用。不过,对于政企合规需求,可以通过Google Cloud Vertex AI实现专属的云端隔离环境,数据是隔离存储的。
Q4:104.8万Token上下文窗口是什么概念,能处理什么文件?
104.8万Token,大概相当于70到80万字的文本。这意味着你可以一次性完整读取整本几十万字的小说、全套企业年度财报、数百页的法律合同,甚至是一个完整的前端或后端代码仓库,完全不需要拆分分段上传。
Q5:模型不联网时知识时效性如何,需要强制开启搜索插件吗?
内置知识库已经更新到2026年3月。对于2026年之前的行业新闻、技术文档、通用知识,直接回答即可,无需联网。如果需要实时资讯或动态数据,再开启谷歌搜索工具插件就行。
Q6:Gemini 3.6 Flash适合做短视频内容审核吗?
非常适合。它原生支持45分钟长视频的逐帧解析,可以批量识别视频画面和音频台词中的违规内容。而且Token消耗低,在批量审核场景下,综合成本优于GPT-4o Mini和Claude 3 Haiku。
Q7:为什么代码场景下3.6 Flash Token节省幅度最高可达65%?
因为模型针对代码逻辑做了专项训练。它会自动剔除无效循环、冗余注释和重复的代码修改,推理时减少多次工具调试的轮次,生成结果一次到位,避免了多轮修正带来的额外Token消耗。
八、总结
一句话总结的话:Gemini 3.6 Flash是谷歌在2026年推出的主力高效多模态大模型,核心优势在于百万级超长上下文、全链路音视频图文原生支持、大幅优化的Token使用效率,以及下调的商用定价。在代码开发、企业自动化智能体、长文档批量处理、长视频解析这些场景中,它有着明确的差异化优势。无论是个人免费试用,还是企业规模化商用,都能找到合适的位置。可以说,这是目前兼顾性能与成本的一个非常均衡的通用云端推理模型,适配绝大多数中低复杂度的多模态、文本和代码类AI落地项目。
-
斋醮音乐指的是哪一种音乐形式 蚂蚁新村今日答案2026.9.13
-
2026年9月15日小鸡庄园答案
-
蚂蚁庄园今日答案2026年9月9日
-
2026年9月21日小鸡庄园答案
-
宋词名句“欲买桂花同载酒”下一句是什么 蚂蚁庄园今日答案9.3
-
支付宝疯狂碰友节这是红箭答案
-
2026年9月13日小鸡庄园答案
-
蚂蚁庄园今日课堂答题2026年9月13日
-
蚂蚁庄园答案2026年9月13日
-
小鸡庄园今天答案2026.9.15
-
小鸡答题今天的答案是什么2026年9月2日
-
蚂蚁庄园小课堂2026年9月3日最新题目答案
-
比海底更深的“超深渊带”是指水深超过多少米
-
支付宝疯狂碰友节这是小提琴答案
-
支付宝疯狂碰友节这是菠萝答案
-
2026年9月9日小鸡庄园答案
-
蚂蚁庄园小鸡答题今日答案2026年9月12日
-
蚂蚁庄园今日答案2026年9月13日
-
小鸡庄园今天答案2026.9.13
-
蚂蚁新村2026年9月13日答案最新
-
1

- 20xx年男朋友生日祝福语大全【超有爱】
- 角色扮演 |
-
2
- 小萝莉美女柳侑绮h头像图片
- 角色扮演 |
-
3
- 20xx年新人结婚祝福短信
- 角色扮演 |
-
4
- 关于小朋友生日祝福语大全
- 角色扮演 |
-
5
- 好看的文艺青年男生带字头像
- 角色扮演 |
-
10 ICML放榜,清华阿里拿下最高奖,谷歌DeepMind再封经典 07-07