AI 功能跑起来以后,麻烦才刚开始:聊聊蒲云 AI
来源:互联网 更新时间:2026-07-22 08:19
图:统一入口把应用、模型服务和异常通道放进同一套调用体系。
给产品接入大模型,第一次上手其实挺顺的。
申请个API Key,装好SDK,照着文档写几十行代码,模型就能跑起来返回结果。做Demo阶段,一个模型、一个项目、一套配置,出了问题也容易定位。
真正的麻烦,通常是从上线之后才开始冒出来的。
产品有了用户,调用量上来了;团队又接了第二个、第三个模型;测试环境和生产环境要分开管理;有人想换一个便宜点的模型跑批量任务,也有人希望核心功能保留更稳的通道。月底账单到了,大家只看到一个总金额,却说不清到底是哪项功能花掉了这笔钱。
这时候,团队需要一个能把模型、密钥、用量和日志放在一起管理的入口。
多接一个模型,维护工作就多一层
直接调用模型厂商的API,短期来看确实最省事。但项目一多,原本简单的接入方式就会慢慢变成一堆零散配置。
OpenAI、Claude、Gemini这些服务,各有各的协议、SDK和鉴权方式。不同项目里可能还写着不同的base_url、模型名、重试逻辑和错误处理。换模型时,改动往往会从配置文件一路蔓延到业务代码和测试用例。
API Key也容易失控。为了图方便,几个人共用一把Key,测试脚本、内部工具和线上服务都从同一个账户扣费。等到调用异常或者费用突然增加,很难查清楚具体来自哪个项目。有人离开团队,或者一个临时项目结束,这把Key也不敢直接停掉,因为谁都不确定还有什么服务还在用。
再往后就是排障。用户只会说一句“刚才没生成出来”,开发者却需要知道那次请求走了哪个模型、用了多少Token、延迟多高、返回了什么状态码。调用分散在多个平台时,这些信息往往要来回翻控制台和日志才能拼凑起来。
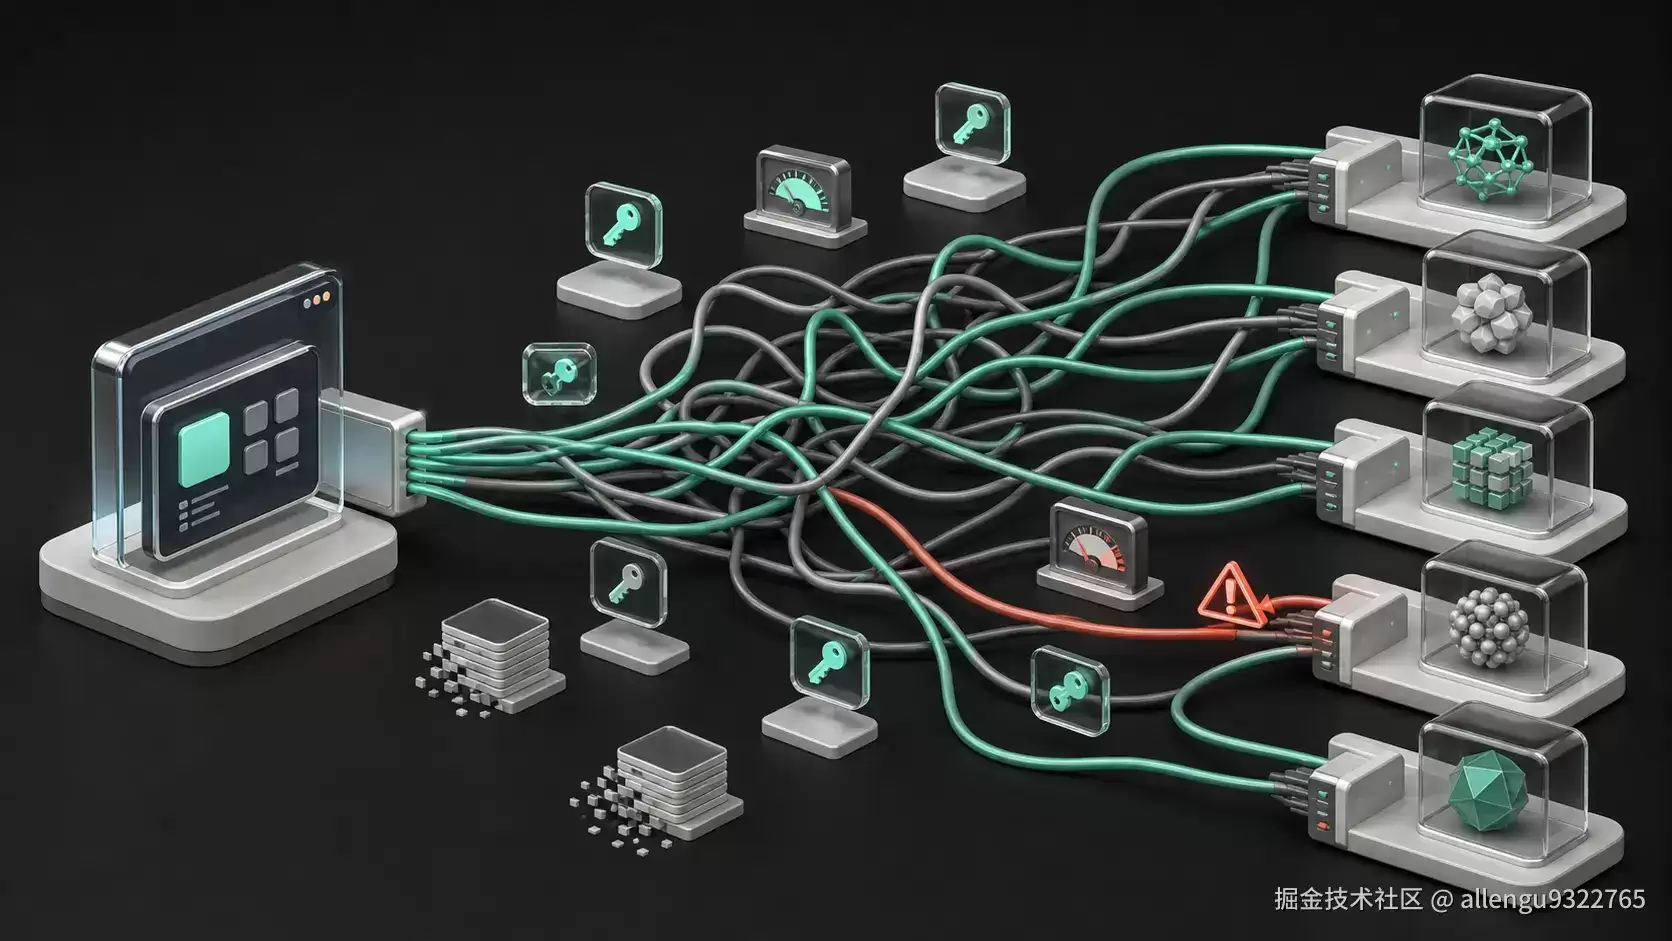
图:每多接一家模型服务,就会多出一套线路、Key、用量和故障处理。
蒲云 AI 把模型调用收进一个入口
蒲云 AI 的做法,是在业务应用和模型服务之间,插入一个统一的大模型API网关。应用还是用熟悉的客户端,只把请求发到统一地址,由网关来处理鉴权、协议转换、路由和记录。
拿OpenAI Python SDK举个例子,接入时主要改的就是API Key和base_url:
from openai import OpenAI

client = OpenAI(
    api_key="sk-your-puyun-key",
    base_url="https://ai.tracup.com/v1",
)

response = client.chat.completions.create(
    model="your-model-name",
    messages=[
        {"role": "user", "content": "请整理这段客户反馈"}
    ],
)
官网目前列出的兼容范围包括OpenAI、Anthropic、Gemini等格式,也支持SSE流式输出、Function Calling和JSON Mode。业务系统、Agent应用,以及Claude Code、Codex这类编程助手,都可以通过对应的兼容协议接入。
对开发者来说,最直接的好处就是少改代码。以后增加或更换模型时,业务逻辑不用跟着每个供应商反复调整。协议、鉴权和上游变化都留在网关这一层处理,应用继续专注自己的功能。
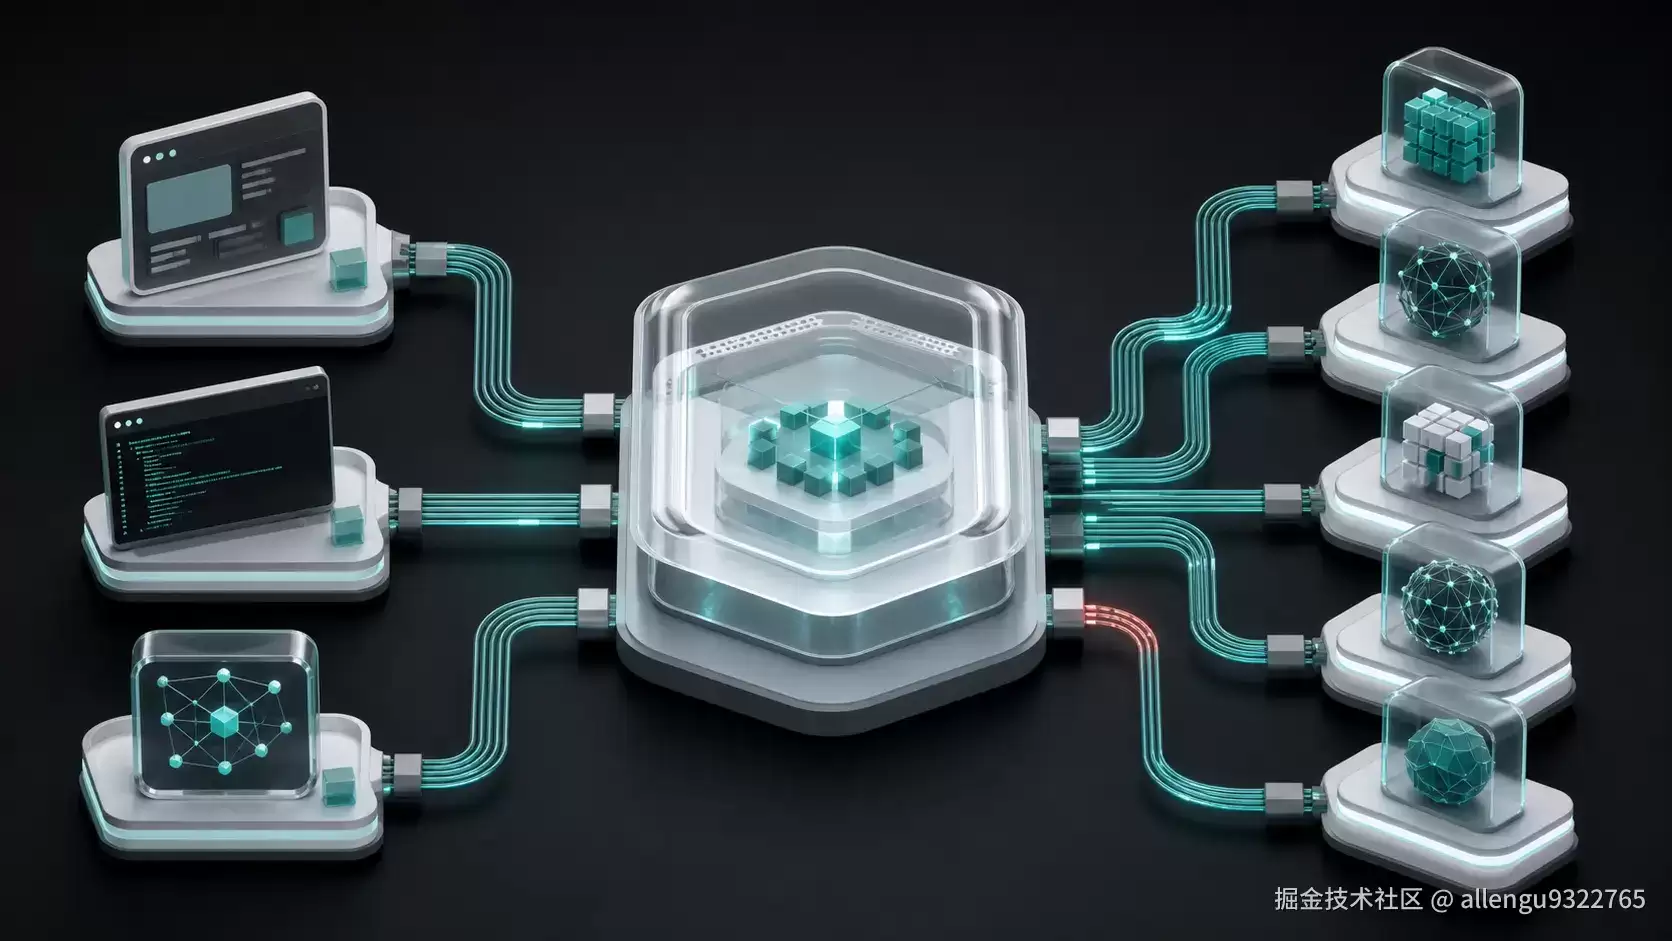
图:业务系统、编程助手和 Agent 先进入统一网关,再由网关连接不同模型。
一把 Key 能调多个模型,还要管好每把 Key
有了统一入口,也不能让所有项目继续共用一把密钥。
蒲云 AI 支持按团队或项目创建独立Key,并设置限速、额度和有效期。实际使用时,可以把生产环境、测试环境、内部脚本和个人调试拆开:
customer-service-prod只给线上客服使用;content-tool-test留给内容工具测试;internal-batch专门跑内部批处理;developer-sandbox用于日常调试,并设置较短的有效期。
这样做以后,停掉一个项目不会影响其他服务,费用也能按用途归集。出现异常调用时,先看对应Key就能把排查范围缩小很多。
账单不必等到月底才看
大模型的费用,跟普通服务器不太一样。一次请求花多少,跟输入长度、输出长度、所选模型、缓存命中情况都有关系。产品刚上线时调用量不大,团队容易忽略;等自动化任务和真实用户一起增长,费用可能在几天内发生明显变化。
蒲云 AI 的用量与成本看板,可以按模型查看Token、延迟和费用明细。消费预警则可以设置预算阈值,通过邮件、Webhook、飞书或钉钉发送提醒。
有了这些数据,成本讨论会具体很多。团队可以看出哪个功能输出过长,哪个测试脚本调用过于频繁,哪些重复请求适合使用Prompt缓存,也能判断低风险任务是否有必要继续使用高成本模型。
只盯着单价,很难把钱省下来。先知道钱花在了哪里,才有机会改对地方。
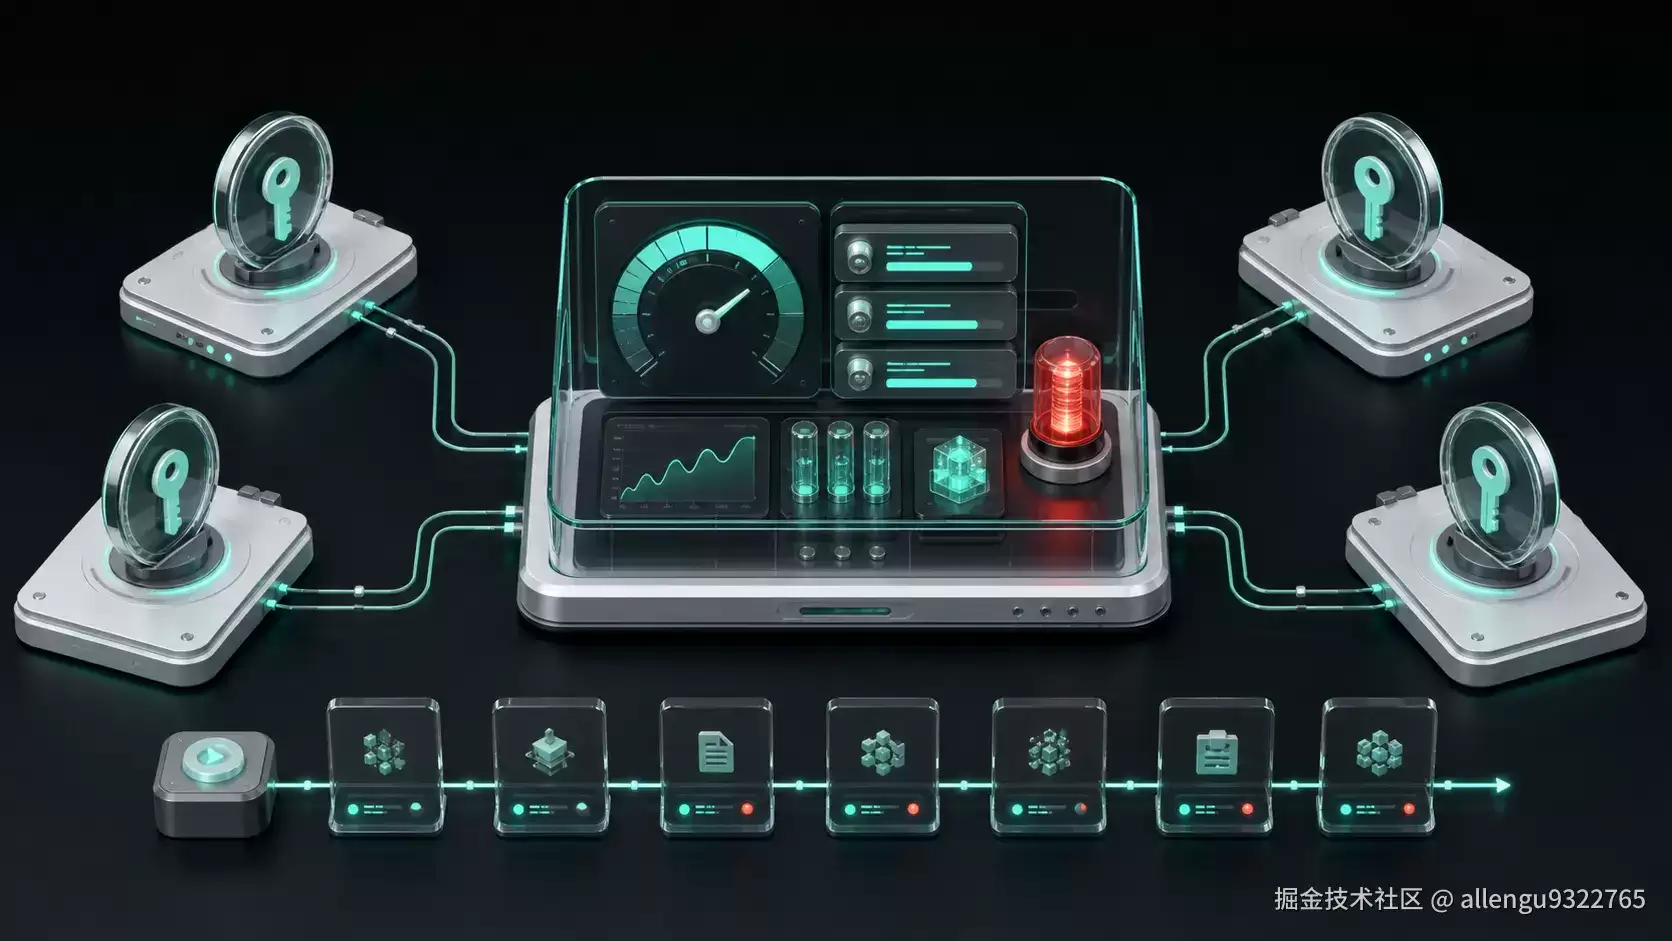
图:项目级 Key、Token 用量、预算告警和请求记录可以在同一处管理。
出问题时,至少知道该从哪里查
模型服务是外部依赖,超时、限流和上游波动都不可避免。蒲云 AI 提供了智能路由与故障切换,并保留请求级审计日志。日志中可以查看模型、Token、延迟和状态码等信息。
当一次生成失败时,开发者不用只靠业务侧的一句报错来猜原因。先确认请求有没有到达网关,再看走了哪个模型、上游返回了什么状态,排障路径会清楚得多。
这里还是要留一个边界:网关可以处理路由、协议和上游切换,但不同模型的输出风格、工具调用细节和效果不会因此自动变得完全一致。准备切换模型时,核心业务仍然需要做回归测试,尤其是结构化输出、长上下文和工具调用场景。
哪些人现在就值得试
如果你只写一个一次性脚本,调用量很小,也没有换模型的计划,直接使用厂商API往往已经够用。没必要为了“架构完整”额外加一层。
下面这些情况,更适合尽早使用统一网关:
- 同时使用两家以上模型服务;
- 在做AI SaaS、RAG、客服、内容工具或Agent;
- 有多个项目、环境或成员需要分别管理Key;
- 需要看清Token用量、延迟和费用去向;
- 线上功能需要备用通道和请求级日志;
- Claude Code、Codex等工具需要灵活切换模型。
可以先拿一个非核心功能试
迁移模型入口,不适合一上来就全量切换。更稳妥的办法,是先选一个影响较小、调用量看得见的功能,比如内部摘要、测试环境的内容分类,或者开发工具中的辅助任务。
接入后跑一段时间,重点看三件事:实际可用的模型是否符合需求,延迟和稳定性是否能接受,账单能不能和自己的调用记录对上。确认这些结果,再决定要不要把更多功能迁过来。
蒲云 AI 官网目前显示“限时有效 1000 万 Token 额度已到账,登录后即可创建 API Key”。活动的具体到账方式、有效期和适用模型,以登录后的账户页面为准。
如果你的AI项目已经从“先调通再说”走到了多模型、多项目和长期运行阶段,可以去 ai.tracup.com 创建一把测试Key。先把一个小功能接进去,看真实数据,再决定下一步。
-
蚂蚁新村今日答案最新2026.9.30
-
职业小知识最新答案10.4
-
蚂蚁庄园今日课堂答题2026年10月1日
-
煤提质工这一职业诞生于哪种时代背景 蚂蚁新村今日答案2026.9.24
-
小鸡答题今天的答案是什么2026年9月20日
-
蚂蚁新村今日答案9.22
-
蚂蚁庄园答案2026年9月23日
-
蚂蚁庄园小课堂2026年10月1日最新题目答案
-
蚂蚁庄园小课堂2026年9月20日最新题目答案
-
2026年9月21日小鸡庄园答案
-
跨经度最广的大洋是
-
蚂蚁庄园今日课堂答题2026年9月30日
-
有鸟有鸟群纸鸢因风假势童子牵描写的是什么场景 蚂蚁新村今日答案2026.9.29
-
2026年9月30日蚂蚁新村答案
-
以下哪一项是海水的主要运动形式
-
蚂蚁庄园小课堂今日最新答案2026年9月21日
-
小鸡庄园今天答案2026.9.23
-
蚂蚁庄园小鸡答题今日答案2026年9月30日
-
蚂蚁新村今日答案最新2026.9.29
-
同样是极地地区,为什么南极有数千米厚的冰雪而北极没有
-
1

- 创意的生日祝福语
- 角色扮演 |
-
2
- 手写生日快乐祝福语图片大全
- 角色扮演 |
-
3
- 异地女朋友生日祝福语大全
- 角色扮演 |
-
4
- 男朋友生日祝福语图片
- 角色扮演 |
-
5
- 男朋友的生日祝福语图片
- 角色扮演 |
-
1 GPT从BERT借鉴了哪些方法和技术? 08-27
-
5 疯狂24h后,openai o1有哪些新的秘密? 08-27
-
6 Pixtral 12B:本地部署、图像分析和OCR功能全解析 08-27
-
9 【RAG】FastEmbed:一种轻量的快速文本嵌入工具 08-27
-
10 必看:Open AI AMA 回答大量关于 o1 的关键性问题 08-27